Making the Pipe Dirty Again via a Use-After-Free in Linux's eventpoll
CVE-2026-43074
Introduction
CVE-2026-43074 là một lỗ hổng use-after-free trong component eventpoll.c của Linux kernel. Khi thêm một epoll mới, kernel duyệt ngược topology dưới RCU read lock và đọc epi->ep để lấy con trỏ tới object eventpoll cha, nhưng không tăng reference count của object đó. Nếu đồng thời một thread khác đóng file descriptor cuối cùng của object, nó sẽ gọi ep_free() với kfree() ngay lập tức, trong khi RCU reader vẫn giữ dangling pointer. Dẫn đến UAF khi kernel ghi lại loop_check_gen và loop_check_depth lên object.
Đây là lỗ hổng 1‑day mình lấy từ submission spreadsheet của KernelCTF, vẫn tồn tại trên Ubuntu 24.04, phiên bản Linux Kernel 6.17.0-35-generic, phiên bản mặc định khi cài đặt. Khi khai thác thành công, mình có thể trigger lại lỗ hổng Dirty Pipe để ghi tùy ý vào file chỉ có quyền đọc và leo quyền. PoC ổn định, thành công đến 99% trong attempt đầu tiên với config mặc định.
Background
Written by AI
Event polling
Một web server thường phải duy trì đồng thời rất nhiều kết nối đến các client. Mỗi kết nối được kernel biểu diễn bằng một socket và được process truy cập thông qua một file descriptor. Thay vì tạo một thread riêng cho từng kết nối rồi đợi tại sysall read(), ứng dụng thường muốn biết socket nào đã có dữ liệu đến để chỉ xử lý những kết nối đó. Trước khi có eventpoll, Linux cung cấp hai syscall select() và poll() cho mục đích này. Process truyền một tập file descriptor cho kernel và yêu cầu chờ đến khi một trong số chúng trở nên ready. Ví dụ sử dụng poll():
// Each client connection has one file descriptor
struct pollfd fds[MAX_CLIENTS];

while (1) {
    // Wait until at least one fd becomes readable
    poll(fds, MAX_CLIENTS, -1); // (fds, number of fds, timeout)

    // Scan every client to find ready sockets
    for (int i = 0; i < MAX_CLIENTS; i++) {
        if (fds[i].revents & POLLIN) { // Data available
            read(fds[i].fd, buf, sizeof(buf));
        }
    }
}
Tuy nhiên, mỗi lần gọi select() hoặc poll(), toàn bộ tập fd phải được truyền lại từ userspace xuống kernel, sau đó kernel phải kiểm tra từng fd để tìm những fd đang sẵn sàng. Với một server duy trì hàng nghìn kết nối nhưng tại một thời điểm chỉ có vài kết nối phát sinh dữ liệu, phần lớn công việc chỉ là quét các fd không có sự kiện.
eventpoll, được userspace sử dụng thông qua syscall epoll, giải quyết vấn đề này bằng cách lưu lâu dài trong kernel tập các file descriptor mà process muốn theo dõi, còn gọi là interest set. Process chỉ cần đăng ký fd một lần bằng epoll_ctl(). Sau đó, khi một fd trong interest set trở nên sẵn sàng cho I/O, callback mà epoll đã đăng ký với kernel sẽ đưa fd đó vào ready list, tức danh sách các fd đã phát sinh sự kiện và có thể được trả về cho userspace. Vì vậy, epoll_wait() chỉ cần lấy các fd đã có trong ready list thay vì phải quét lại toàn bộ interest set sau mỗi lần gọi.
Trong kernel, mỗi lần epoll_create1() tạo ra một epoll instance, instance đó được biểu diễn bởi struct eventpoll.
struct eventpoll {
	struct mutex mtx;
	wait_queue_head_t wq;
	wait_queue_head_t poll_wait;
	struct list_head rdllist;
	spinlock_t lock;
	struct rb_root_cached rbr;
	struct epitem *ovflist;
	struct wakeup_source *ws;
	struct user_struct *user;
	struct file *file;
	u64 gen;
	struct hlist_head refs;
	u8 loop_check_depth;
	refcount_t refcount;
#ifdef CONFIG_NET_RX_BUSY_POLL
	unsigned int napi_id;
	u32 busy_poll_usecs;
	u16 busy_poll_budget;
	bool prefer_busy_poll;
#endif
#ifdef CONFIG_DEBUG_LOCK_ALLOC
	u8 nests;
#endif
};
Mỗi fd được thêm bằng EPOLL_CTL_ADD lại được biểu diễn bởi một struct epitem.
struct epitem {
	union {
		struct rb_node rbn;
		struct rcu_head rcu;
	};
	struct list_head rdllink;
	struct epitem *next;
	struct epoll_filefd ffd;
	bool dying;
	struct eppoll_entry *pwqlist;
	struct eventpoll *ep;
	struct hlist_node fllink;
	struct wakeup_source __rcu *ws;
	struct epoll_event event;
};
eventpoll là container, còn epitem là quan hệ giữa container đó và một fd đang được theo dõi.
Ở struct eventpoll, rbr là root của red-black tree chứa toàn bộ epitem thuộc epoll instance này. Khi thêm một fd, kernel tạo một epitem rồi chèn node epi->rbn vào ep->rbr.
Field ep trong struct epitem trỏ ngược về eventpoll sở hữu nó. Giả sử epoll A watch socket S, kernel sẽ tạo một epitem có:
epi->ep = A;Vậy khi duyệt A->rbr, kernel có thể biết A đang watch những fd nào, còn từ một epitem, epi->ep cho biết epoll nào đã tạo ra watch này.
Tuy nhiên, kernel còn cần chiều ngược lại là từ một struct file, xác định những epoll nào đang watch file đó. Field fllink trong epitem được dùng để nối epitem vào danh sách reverse reference của file được watch. Được sử dụng khi file bị đóng, vì kernel phải tìm và gỡ tất cả epitem đang tham chiếu tới file đó.
Khi target là một epoll khác, reverse list này chính là field refs của target eventpoll. Giả sử epoll A watch epoll B. Kernel tạo một epitem gọi là epi_AB và thiết lập quan hệ. Ví dụ sử dụng epoll dựng một topology đơn giản như sau, B watch một socket S, còn A watch B:
// Create a socket and two epoll instances
int sock = socket(...);
int epA  = epoll_create1(0);
int epB  = epoll_create1(0);

// epoll B watches the socket
struct epoll_event ev = {
    .events = EPOLLIN,
};

epoll_ctl(epB, EPOLL_CTL_ADD, sock, &ev);

// epoll A watches epoll B
ev.data.fd = epB;
epoll_ctl(epA, EPOLL_CTL_ADD, epB, &ev);

// Wait on epoll A
epoll_wait(epA, events, MAX_EVENTS, -1);
Các struct được liên kết với nhau như sơ đồ dưới đây:
  classDiagram
direction TB

class eventpoll_A {
    +rb_root_cached rbr
    +u64 gen
    +hlist_head refs
    +u8 loop_check_depth
    +refcount_t refcount
}

class epitem_AB {
    +epitem* next
    +eventpoll* ep
    +hlist_node fllink
}

class eventpoll_B {
    +rb_root_cached rbr
    +u64 gen
    +hlist_head refs
    +u8 loop_check_depth
    +refcount_t refcount
}

class epitem_BS {
    +epitem* next
    +eventpoll* ep
    +hlist_node fllink
}

class socket_file {
    +struct file
    +socket target
    +reverse reference list
}

eventpoll_A *-- epitem_AB : A.rbr lưu watch A → B
epitem_AB --> eventpoll_A : ep trỏ về owner là A
eventpoll_B o-- epitem_AB : B.refs chứa epitem_AB.fllink vì B đang bị A watch

eventpoll_B *-- epitem_BS : B.rbr lưu watch B → socket
epitem_BS --> eventpoll_B : ep trỏ về owner là B
socket_file o-- epitem_BS : reverse list chứa epitem_BS.fllink để biết B đang watch socket
Khi socket ready, B trở thành readable. Trạng thái này tiếp tục đánh thức A, nên userspace đang chờ trên A có thể biết rằng nhánh bên dưới B đang có event.
Một epoll có thể được nhiều epoll khác watch, nên cấu trúc có thể là một directed acyclic graph. Tuy nhiên, kernel không cho phép tạo cycle. Nếu cycle tồn tại, đánh thức tiếp tục được truyền qua lại giữa các epoll, tăng số lần đệ quy và sử dụng thêm stack. Vì vậy, khi thêm một epoll vào epoll khác, kernel kiểm tra topology trước khi chèn epitem.
Read-copy-update (RCU)
RCU, viết tắt của Read-Copy-Update, là cơ chế đồng bộ được tối ưu cho trường hợp dữ liệu được đọc thường xuyên nhưng chỉ thỉnh thoảng mới bị thay đổi. Ý tưởng chính là reader có thể truy cập object mà không cần tranh chấp một lock chung, còn writer phải bảo đảm object vẫn tồn tại cho đến khi mọi reader cũ đã sử dụng xong.
Nhiều CPU có thể cùng chạy trong rcu_read_lock() và đọc cùng một object tại cùng thời điểm. Reader này không chặn reader khác, cũng không cần tăng reference count trên từng object.
rcu_read_lock();

obj = rcu_dereference(global_obj);
if (obj)
    use(obj);

rcu_read_unlock();
rcu_read_lock() đánh dấu một RCU read-side critical section. rcu_dereference() lấy pointer đã được writer publish.
Quan hệ giữa reader và writer phụ thuộc vào writer đang làm gì. Trường hợp đầu tiên là writer sửa trực tiếp object hiện tại:
obj->value = new_value;RCU tự nó không làm thao tác này an toàn. Reader và writer vẫn có thể truy cập cùng một vùng nhớ đồng thời. Reader có thể thấy giá trị cũ hoặc giá trị mới. Nếu writer cập nhật nhiều field, reader còn có thể thấy trạng thái trung gian, trong đó một field đã mới nhưng field khác vẫn cũ. Vì vậy, khi writer sửa trực tiếp object đã được publish, vẫn cần một cơ chế khác như spinlock, mutex, atomic operation hoặc seqcount, tùy loại dữ liệu. Với một field độc lập, READ_ONCE() và WRITE_ONCE() có thể bảo đảm mỗi lần đọc hoặc ghi được thực hiện đúng một lần trên chính field đó. Tuy nhiên, chúng không bảo đảm reader sẽ thấy nhiều field thuộc cùng một phiên bản dữ liệu.
Trường hợp thứ hai là writer không sửa object hiện tại mà tạo một object mới, khởi tạo rồi thay pointer cũ bằng pointer mới. Writer thực hiện ba bước. Đầu tiên, tạo và khởi tạo object mới. Tiếp theo, publish pointer mới bằng rcu_assign_pointer(). Cuối cùng, chỉ giải phóng object cũ sau một RCU grace period (sau khi tất cả reader có khả năng đã lấy pointer old đều rời khỏi RCU read-side critical section). Sau khi pointer mới được publish, các reader mới sẽ lấy object mới. Những reader đã lấy pointer cũ trước đó vẫn được phép tiếp tục sử dụng object cũ. Writer không chờ reader trong lúc thay pointer, writer chỉ phải trì hoãn việc free object cũ.
RCU không bảo đảm writer với writer được serialize. Nếu hai writer cùng update mà không có lock, thay đổi của writer chạy sau có thể ghi đè thay đổi của writer chạy trước. Ngoài ra, một object vừa được tạo có thể bị pointer khác ghi đè trước khi được sử dụng, khiến object đó không còn đường tham chiếu và bị leak.
Vì vậy, writer thường vẫn cần một lock:
spin_lock(&update_lock);

/* đọc trạng thái cũ, tạo trạng thái mới và thay pointer */

spin_unlock(&update_lock);
Lock buộc các writer thực hiện update lần lượt, tránh việc chúng cùng sửa hoặc thay pointer tại một thời điểm. Reader không cần lấy lock này vì vẫn đọc thông qua RCU. Vì vậy, cách dùng phổ biến là reader được bảo vệ bởi RCU, còn writer dùng lock để đồng bộ với writer khác và dùng rcu_assign_pointer() để publish object mới cho reader. Ví dụ, ta có một object được quản lý bằng RCU:
struct my_object {
    int value;            // Data protected by RCU
    struct rcu_head rcu;  // Used by kfree_rcu()
};

struct my_object __rcu *global_obj; // Shared RCU-protected pointer
DEFINE_SPINLOCK(update_lock);       // Serialize concurrent writers
Reader truy cập object như sau:
void read_value(void)
{
    struct my_object *obj;

    rcu_read_lock(); // Enter RCU read-side critical section

    obj = rcu_dereference(global_obj); // Safely load current object
    if (obj)
        consume(obj->value); // Use the object without locking

    rcu_read_unlock(); // Reader is done
}
Writer tạo object mới rồi thay object hiện tại:
int update_value(int value)
{
    struct my_object *new;
    struct my_object *old;

    new = kmalloc(sizeof(*new), GFP_KERNEL); // Allocate new version
    if (!new)
        return -ENOMEM;

    new->value = value; // Initialize new object

    spin_lock(&update_lock); // Serialize writers

    old = rcu_dereference_protected(
        global_obj,
        lockdep_is_held(&update_lock)
    ); // Get old object under the lock

    rcu_assign_pointer(global_obj, new); // Publish new version

    spin_unlock(&update_lock);

    if (old)
        kfree_rcu(old, rcu); // Free old object after grace period

    return 0;
}
rcu_assign_pointer() publish new sau khi toàn bộ field của object đã được khởi tạo. kfree_rcu(old, rcu) không gọi kfree() ngay lập tức. Nó đăng ký việc giải phóng old sau khi kết thúc một grace period.
Không được viết như sau:
rcu_assign_pointer(global_obj, new);
kfree(old);
Một reader có thể đã lấy old ngay trước khi writer thay pointer nhưng vẫn chưa sử dụng xong object. kfree(old) lúc này tạo ra use-after-free.
Một cách tương đương nhưng synchronous là:
rcu_assign_pointer(global_obj, new);
synchronize_rcu();
kfree(old);
synchronize_rcu() bắt writer đứng chờ cho đến khi grace period kết thúc rồi mới tiếp tục. Còn kfree_rcu() chỉ lên lịch giải phóng object sau grace period, nên writer có thể tiếp tục chạy ngay mà không phải chờ tại chỗ.
Patch examining
Patch https://git.kernel.org/pub/scm/linux/kernel/git/stable/linux.git/commit/?id=5b1173b16542 fix một lỗi về lifetime trong eventpoll.c.
Trước patch, ep_free() gọi trực tiếp kfree(ep), trong khi một thread khác vẫn có thể giữ pointer tới struct eventpoll bên trong RCU read-side critical section.
diff --git a/fs/eventpoll.c b/fs/eventpoll.c
index aa4318271eee4..075aa8793aaa9 100644
--- a/fs/eventpoll.c
+++ b/fs/eventpoll.c
@@ -226,6 +226,9 @@ struct eventpoll {
 	 */
 	refcount_t refcount;

+	/* used to defer freeing past ep_get_upwards_depth_proc() RCU walk */
+	struct rcu_head rcu;
+
 #ifdef CONFIG_NET_RX_BUSY_POLL
 	/* used to track busy poll napi_id */
 	unsigned int napi_id;
@@ -790,7 +793,8 @@ static void ep_free(struct eventpoll *ep)
 	mutex_destroy(&ep->mtx);
 	free_uid(ep->user);
 	wakeup_source_unregister(ep->ws);
-	kfree(ep);
+	/* ep_get_upwards_depth_proc() may still hold epi->ep under RCU */
+	kfree_rcu(ep, rcu);
 }

 /*
Patch bổ sung struct rcu_head vào eventpoll và thay kfree() bằng kfree_rcu(), trì hoãn việc giải phóng vùng nhớ cho đến khi các RCU reader hiện tại đã kết thúc.
Vulnerability analysis
Giả sử đã tồn tại topology A -> B, tức epoll A đang watch epoll B. Khi đó, B->refs chứa một epitem thuộc A, và epi->ep trỏ ngược về A. Đồng thời, một thread khác thực hiện EPOLL_CTL_ADD để thêm một epoll mới vào B.
Trong do_epoll_ctl(), kernel lấy struct eventpoll của epoll target qua file->private_data. Vì target được thêm vào cũng là một epoll, thao tác này yêu cầu full topology check và gọi ep_loop_check(ep, tep).
int do_epoll_ctl(int epfd, int op, int fd, struct epoll_event *epds,
		 bool nonblock)
{
	int error;
	int full_check = 0;
	struct eventpoll *ep;
	struct epitem *epi;
	struct eventpoll *tep = NULL;

	...
	error = epoll_mutex_lock(&ep->mtx, 0, nonblock);
	if (error)
		goto error_tgt_fput;
	if (op == EPOLL_CTL_ADD) {
		if (READ_ONCE(fd_file(f)->f_ep) || ep->gen == loop_check_gen ||
		    is_file_epoll(fd_file(tf))) {
			mutex_unlock(&ep->mtx);
			error = epoll_mutex_lock(&epnested_mutex, 0, nonblock);
			if (error)
				goto error_tgt_fput;
			loop_check_gen++;
			full_check = 1;
			if (is_file_epoll(fd_file(tf))) {
				tep = fd_file(tf)->private_data;
				error = -ELOOP;
				if (ep_loop_check(ep, tep) != 0) // <-------- HERE
					goto error_tgt_fput;
			}
			error = epoll_mutex_lock(&ep->mtx, 0, nonblock);
			if (error)
				goto error_tgt_fput;
		}
	}
	...

	return error;
}
ep_loop_check() trước tiên kiểm tra topology bên dưới target bằng ep_loop_check_proc(). Sau đó, hàm đi ngược từ epoll đang được thêm vào bằng ep_get_upwards_depth_proc(). Phần duyệt ngược được đặt bên trong rcu_read_lock() vì danh sách ep->refs có thể thay đổi đồng thời tại thread khác.
static int ep_loop_check(struct eventpoll *ep, struct eventpoll *to)
{
	int depth, upwards_depth;

	inserting_into = ep;

	depth = ep_loop_check_proc(to, 0);
	if (depth > EP_MAX_NESTS)
		return -1;

	rcu_read_lock();
	upwards_depth = ep_get_upwards_depth_proc(ep, 0); // <-------- HERE
	rcu_read_unlock();

	return (depth+1+upwards_depth > EP_MAX_NESTS) ? -1 : 0;
}
Trong ep_get_upwards_depth_proc(), kernel duyệt ep->refs bằng hlist_for_each_entry_rcu(). Với mỗi epitem, hàm lấy epi->ep rồi đệ quy lên parent epoll:
static int ep_get_upwards_depth_proc(struct eventpoll *ep, int depth)
{
	int result = 0;
	struct epitem *epi;

	if (ep->gen == loop_check_gen)
		return ep->loop_check_depth;
	hlist_for_each_entry_rcu(epi, &ep->refs, fllink)
		result = max(result, ep_get_upwards_depth_proc(epi->ep, depth + 1) + 1); // <-------- HERE
	ep->gen = loop_check_gen;
	ep->loop_check_depth = result;
	return result;
}
hlist_for_each_entry_rcu() được expand ra có dạng gần giống như sau:
node = rcu_dereference_raw(hlist_first_rcu(&ep->refs));

while (node) {
    epi = hlist_entry_safe(node, struct epitem, fllink);
    result = max(result, ep_get_upwards_depth_proc(epi->ep, depth + 1) + 1);
    node = rcu_dereference_raw(hlist_next_rcu(&epi->fllink));
}
Ở topology trên, khi hàm đang duyệt B->refs, nó có thể lấy được epi->ep == A. RCU bảo đảm epitem vừa đọc không bị giải phóng ngay trong lúc duyệt, nhưng code không tăng refcount cho A (quan trọng!).
Cùng lúc đó, một thread khác đóng epoll A. Release path bắt đầu tại ep_eventpoll_release(), sau đó gọi ep_clear_and_put(A).
static int ep_eventpoll_release(struct inode *inode, struct file *file)
{
	struct eventpoll *ep = file->private_data;

	if (ep)
		ep_clear_and_put(ep); // <-------- HERE

	return 0;
}
static void ep_clear_and_put(struct eventpoll *ep)
{
struct rb_node *rbp, *next;
struct epitem *epi;
if (waitqueue_active(&ep->poll_wait))
ep_poll_safewake(ep, NULL, 0);
mutex_lock(&ep->mtx);
for (rbp = rb_first_cached(&ep->rbr); rbp; rbp = rb_next(rbp)) {
epi = rb_entry(rbp, struct epitem, rbn);
ep_unregister_pollwait(ep, epi);
cond_resched();
}
for (rbp = rb_first_cached(&ep->rbr); rbp; rbp = next) {
next = rb_next(rbp);
epi = rb_entry(rbp, struct epitem, rbn);
ep_remove_safe(ep, epi);
cond_resched();
}
mutex_unlock(&ep->mtx);
if (ep_refcount_dec_and_test(ep))
ep_free(ep); // <-------- HERE
}ep_clear_and_put() lần lượt unregister các poll callback rồi gọi ep_remove_safe() để loại bỏ toàn bộ epitem thuộc A. Việc này cũng gỡ epitem biểu diễn cạnh A -> B khỏi B->refs. Tuy nhiên, RCU reader có thể đã lấy được epitem này trước khi nó bị gỡ, nên reader vẫn tiếp tục nhìn thấy giá trị cũ của epi->ep.
Sau khi các epitem đã được loại bỏ, ep_clear_and_put() giảm refcount của A. Nếu đây là reference cuối cùng, hàm gọi ep_free(A). Trước patch, ep_free() gọi kfree(A) ngay lập tức:
static void ep_free(struct eventpoll *ep)
{
	ep_resume_napi_irqs(ep);
	mutex_destroy(&ep->mtx);
	free_uid(ep->user);
	wakeup_source_unregister(ep->ws);
	kfree(ep); // <-------- HERE
}
epi vẫn còn hợp lệ đối với RCU reader, nhưng epi->ep đã trở thành dangling pointer do không được tăng reference khi sử dụng. Lần đệ quy tiếp theo sẽ đọc A->gen, duyệt A->refs, rồi có thể ghi vào A->gen và A->loop_check_depth sau khi A đã bị free.
Root cause nằm ở sự bất đồng bộ giữa hai lifetime: epitem và sau đó là eventpoll được duyệt dưới RCU, nhưng eventpoll được tham chiếu qua epi->ep lại bị giải phóng bằng kfree() mà không chờ ra khỏi RCU. Sau patch, ep_free() sử dụng kfree_rcu(ep, rcu). A vẫn có thể bị loại khỏi topology và giảm refcount về 0, nhưng backing memory của A được giữ lại cho đến khi Thread 1 rời khỏi rcu_read_unlock(). Khi RCU kết thúc, không còn reader cũ nào có thể sử dụng epi->ep, lúc đó kernel mới giải phóng A. Nhưng cần làm rõ là kfree_rcu(ep, rcu) ở đây không có ý nghĩa là “bảo vệ” việc đọc A an toàn, vì A không được lấy từ rcu_dereference(), mà có ý nghĩa để đảm bảo rằng A không bị giải phóng trong khi đang traverse trong RCU section.
Exploitation
Theo phân tích ở trên, nếu race thành công, mình sẽ có được một UAF write vào object eventpoll tại hai field gen và loop_check_depth. Mục tiêu là phải xây dựng topology sao cho thread thực hiện traversal vẫn giữ pointer tới object eventpoll đã bị free đủ lâu để thread còn lại có thể reclaim vùng nhớ đó.
Mình xét topology đơn giản đã dùng trong các ví dụ trước:
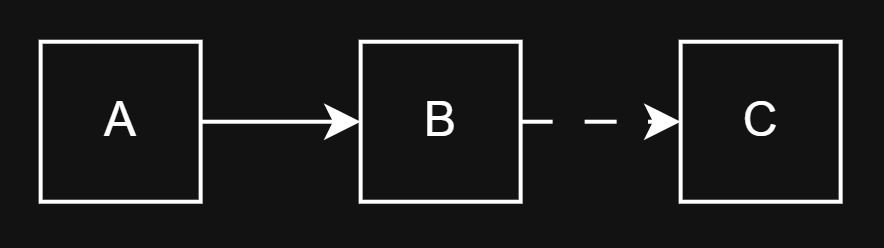
Epoll A watch epoll B. Hai thread được chạy đồng thời:
- Thread 1 thực hiện
do_epoll_ctl(B, EPOLL_CTL_ADD, C), từ đó gọiep_loop_check(B, C). - Thread 2 thực hiện
close(A).
Trong ep_loop_check(B, C), kernel gọi ep_get_upwards_depth_proc(B, 0). Hàm này duyệt B->refs, lấy được epi->ep trỏ tới A, rồi đệ quy vào:
ep_get_upwards_depth_proc(A, 1);Race window bắt đầu tại thời điểm này. Ngay sau khi thread 1 lấy được pointer tới A và bắt đầu xử lý A, thread 2 gọi close(A):
close(A)
    -> ep_clear_and_put(A)
        -> ep_free(A)
            -> kfree(A)
Sau đó spray một object khác để reclaim vùng nhớ vừa thuộc về A trước khi thread 1 thực hiện các phép ghi:
ep->gen = loop_check_gen;
ep->loop_check_depth = result;
Khi ep_get_upwards_depth_proc(A, 1) kết thúc, ep vẫn chứa địa chỉ cũ của A nhưng vùng nhớ đó đã được reclaim. Hai phép gán trên gây UAF write vào object mình kiểm soát.
Tuy nhiên, với topology hiện tại, khoảng thời gian từ lúc ep_get_upwards_depth_proc(A, 1) bắt đầu đến khi nó ghi lại gen và loop_check_depth là rất ngắn. Thread 2 rất khó để hoàn thành cả chuỗi free và reclaim A trong race window này. Vậy mình cần kéo dài thời gian xử lý bên trong lời gọi đệ quy trên A.
Expanding the race window
Ý tưởng là làm cho ep_get_upwards_depth_proc(A, 1) phải duyệt nhiều phần tử hơn. Vì hàm này duyệt các epoll đang watch A, mình có thể tạo nhiều epoll W cùng watch A:
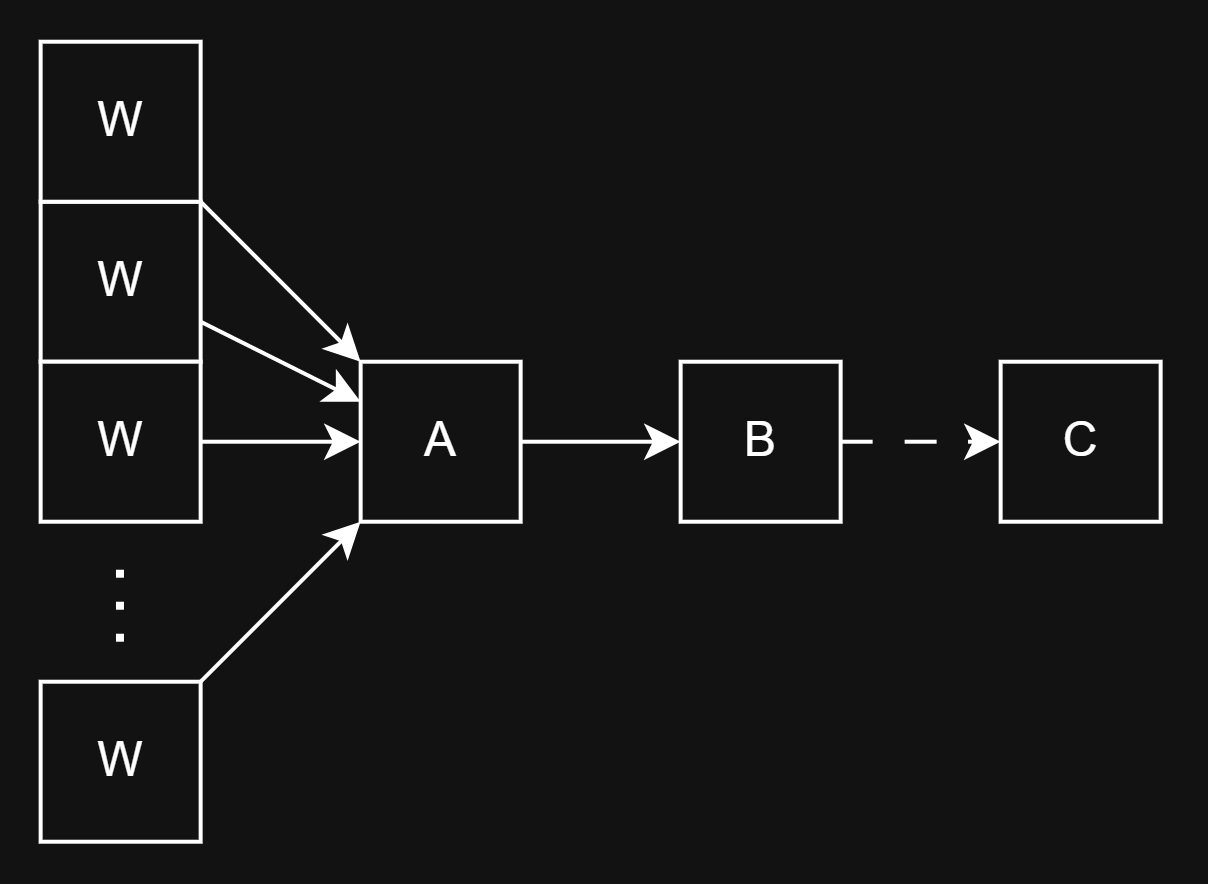
Khi thread 1 xử lý A, nó phải duyệt qua toàn bộ các cạnh W → A. Tuy nhiên, topology này không kéo dài race window theo cách mong muốn.
Trong lúc thread 1 đang duyệt các watcher của A, thread 2 thực hiện close(A) và đi vào ep_clear_and_put(A). Hàm này lần lượt loại bỏ các epitem liên quan đến A, bao gồm các cạnh W → A và A → B. Vì vậy, danh sách mà thread 1 cần duyệt bị thu hẹp đồng thời với quá trình traversal. Số lượng W càng lớn thì close(A) cũng càng chậm do phải tháo gỡ nhiều epitem. Vậy việc đặt trực tiếp nhiều watcher trên A vừa tăng chi phí giải phóng A, vừa không bảo đảm thread 1 xử lý toàn bộ các watcher đó.
Mình giải quyết vấn đề bằng cách chỉ tạo một epoll W watch A, sau đó đặt phần lớn workload ở tầng phía trên W: tạo nhiều epoll Y cùng watch W.
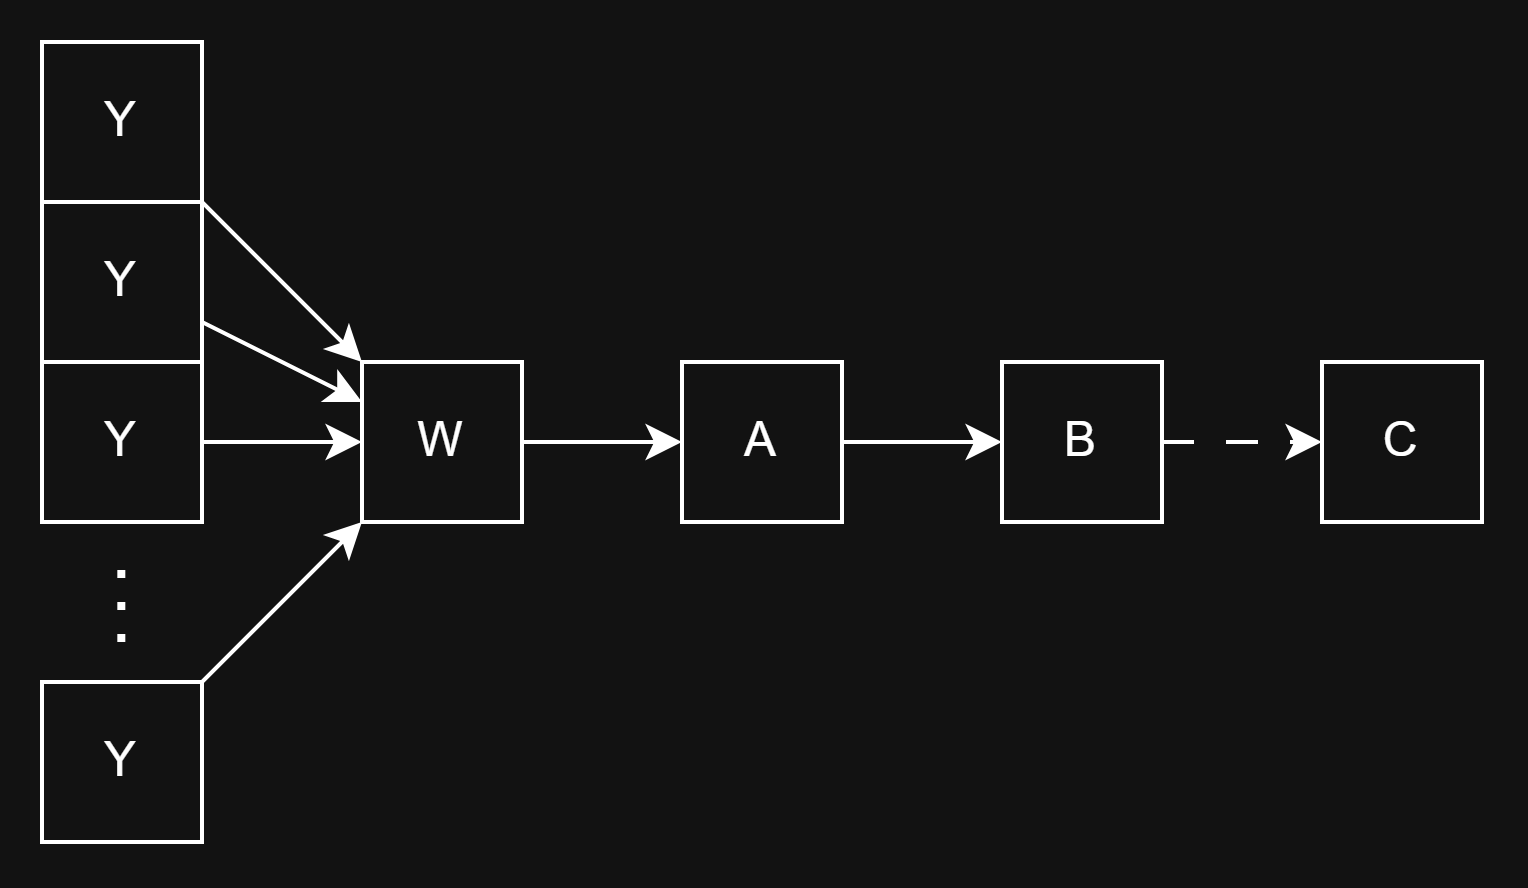
Khi traversal đi từ A lên W, thread 1 gọi:
ep_get_upwards_depth_proc(W, 2);Lời gọi này phải duyệt toàn bộ các watcher Y của W. Trong khi đó, close(A) chỉ cần tháo gỡ cạnh W → A và A → B. Nó không sửa đổi các cạnh Y → W. Do đó, sau khi thread 1 đã đi vào W, thời gian duyệt các Y được tách khỏi quá trình free A. Thread 2 có thể free và reclaim A trong lúc thread 1 vẫn đang xử lý traversal phía trên W.
Mình có thể mở rộng topology thêm một tầng nữa. Mỗi epoll Y được watch bởi nhiều epoll X:
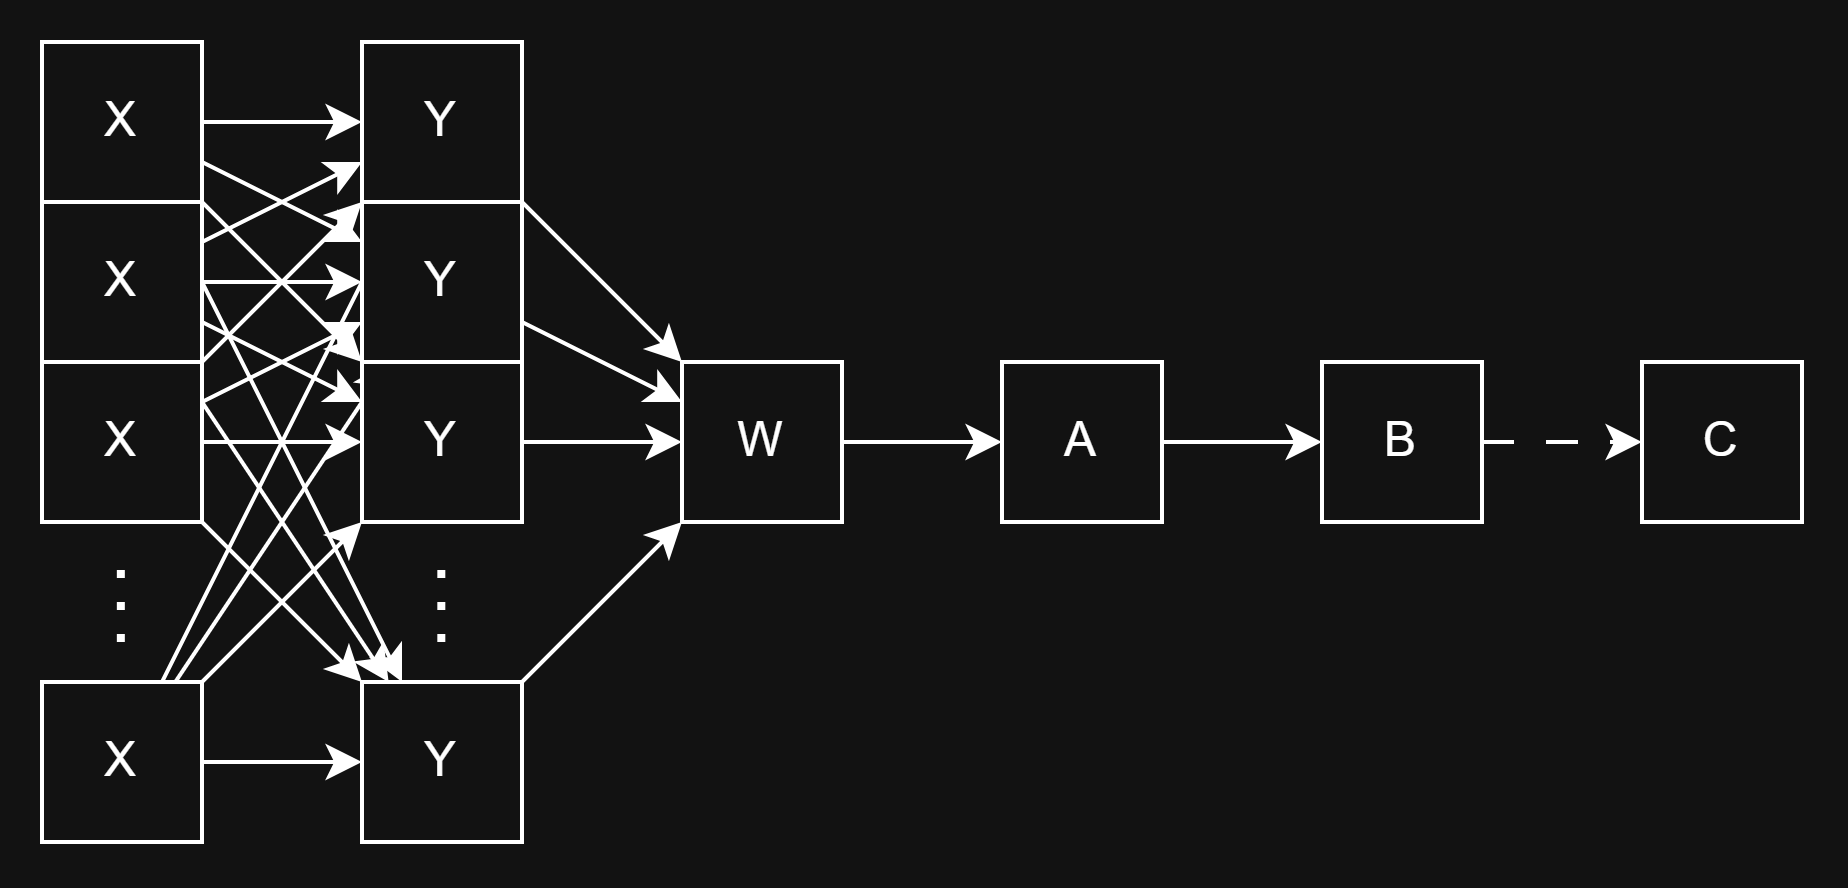
Khi ep_get_upwards_depth_proc() xử lý từng Y, nó tiếp tục duyệt các watcher X của Y. Tổng lượng công việc lúc này phụ thuộc vào cả số lượng Y và số cạnh X → Y. Trong khi đó, close(A) vẫn chỉ tác động đến các quan hệ trực tiếp gắn với A.
Topology này đẩy workload traversal lên các tầng không bị ep_clear_and_put(A) chỉnh sửa. Thread 1 nằm bên trong chuỗi đệ quy đủ lâu, còn thread 2 chỉ cần hoàn thành việc free và reclaim A trước khi thread quay về thực hiện hai lệnh ghi.
Đến đây mình đã chạm giới hạn nesting của epoll. ep_loop_check() không cho phép topology có độ sâu vượt quá EP_MAX_NESTS:
/* Maximum number of nesting allowed inside epoll sets */
#define EP_MAX_NESTS 4

static int ep_loop_check(struct eventpoll *ep, struct eventpoll *to)
{
	...
	return (depth+1+upwards_depth > EP_MAX_NESTS) ? -1 : 0;
}
Vì vậy, không thể tiếp tục thêm một tầng watcher khác để kéo dài traversal. Topology X → Y → W → A → B đã sử dụng hết độ sâu cho phép.
Một giới hạn khác là số lượng file descriptor và lượng RAM khả dụng. Mỗi mũi tên trong topology tương ứng với một epitem, nên chi phí bộ nhớ tăng theo số cạnh chứ không chỉ theo số lượng epoll. Đặc biệt, nếu mỗi X watch nhiều Y, số epitem có thể tăng rất nhanh.
Vậy số lượng X và Y phải được tinh chỉnh sao cho thời gian traversal đủ dài để hoàn thành free và reclaim, nhưng tổng số fd và epitem vẫn nằm trong giới hạn cho phép.
Looking for victim object
Giả sử race window đã đủ dài và mình race thành công và có được primitive ghi vào ep->gen và ep->loop_check_depth. Vấn đề tiếp theo là phải chọn victim object có layout tương thích với hai write này.
Trước hết, mình cần xác định kích thước của struct eventpoll, đồng thời tìm offset và kích thước của hai field bị ghi bằng pahole:
$ pahole -C eventpoll
struct eventpoll {
	struct mutex               mtx;                  /*     0    32 */
	wait_queue_head_t          wq;                   /*    32    24 */
	wait_queue_head_t          poll_wait;            /*    56    24 */
	/* --- cacheline 1 boundary (64 bytes) was 16 bytes ago --- */
	struct list_head           rdllist;              /*    80    16 */
	spinlock_t                 lock;                 /*    96     4 */

	/* XXX 4 bytes hole, try to pack */

	struct rb_root_cached      rbr;                  /*   104    16 */
	struct epitem *            ovflist;              /*   120     8 */
	/* --- cacheline 2 boundary (128 bytes) --- */
	struct wakeup_source *     ws;                   /*   128     8 */
	struct user_struct *       user;                 /*   136     8 */
	struct file *              file;                 /*   144     8 */
	u64                        gen;                  /*   152     8 */
	struct hlist_head          refs;                 /*   160     8 */
	u8                         loop_check_depth;     /*   168     1 */

	/* XXX 3 bytes hole, try to pack */

	refcount_t                 refcount;             /*   172     4 */
	unsigned int               napi_id;              /*   176     4 */
	u32                        busy_poll_usecs;      /*   180     4 */
	u16                        busy_poll_budget;     /*   184     2 */
	bool                       prefer_busy_poll;     /*   186     1 */

	/* size: 192, cachelines: 3, members: 18 */
	/* sum members: 180, holes: 2, sum holes: 7 */
	/* padding: 5 */
};
struct eventpoll có kích thước 192 byte. Field gen là một giá trị u64 nằm tại offset 152, refs nằm tại offset 160, còn loop_check_depth là một giá trị u8 nằm tại offset 168.
Vậy primitive hiện tại gồm hai write:
offset 152: ghi 8 byte từ loop_check_gen
offset 168: ghi 1 byte từ result
Giá trị ghi vào offset 152 không hoàn toàn tùy ý. loop_check_gen được khởi tạo bằng 0 và tăng dần mỗi khi quá trình loop checking được thực hiện. Mình có thể tác động đến giá trị này bằng cách trigger thêm các lần kiểm tra, nhưng thực tế nó vẫn chỉ là một counter. Mình không thể tăng nó đến vùng canonical kernel address hoặc chọn tùy ý toàn bộ 64 bit. Do đó, victim object không nên chứa pointer hoặc giá trị nhạy cảm overlap với dải byte [152, 160), ví dụ như object có pointer nằm tại offset 152, hoặc 148, 156 chẳng hạn.
Còn loop_check_depth chỉ nhận giá trị trong khoảng từ 0 đến 4. Mình cũng chưa có kết luận cho field này.
Ngoài hai write trên, trong quá trình traversal, ep_get_upwards_depth_proc() coi vùng nhớ reclaim là một struct eventpoll và duyệt ep->refs. Vì vậy, 8 byte tại offset 160, tương ứng với refs.first, và phải bằng NULL. Nếu victim object đặt một giá trị khác NULL tại đây, kernel sẽ coi nó là phần tử đầu tiên của một hlist và tiếp tục dereference địa chỉ không hợp lệ, gây kernel panic trước khi write hoàn tất.
struct eventpoll được cấp phát trong ep_alloc() bằng kzalloc(sizeof(*ep), GFP_KERNEL):
static int ep_alloc(struct eventpoll **pep)
{
	struct eventpoll *ep;

	ep = kzalloc(sizeof(*ep), GFP_KERNEL);
	if (unlikely(!ep))
		return -ENOMEM;
	...

	return 0;
}
Trên Ubuntu 24.04, do CONFIG_RANDOM_KMALLOC_CACHES được bật mặc định, vì vậy allocation 192 byte từ ep_alloc() không nhất thiết đến từ general cache kmalloc-192, mà có thể nằm trong randomized cache kmalloc-rnd-XX-192. Randomized cache được chọn dựa trên callsite kết hợp với một per-boot random seed, nên trong cùng một boot mọi allocation đi qua cùng callsite trong ep_alloc() vẫn đi vào cùng một kmalloc-rnd-XX-192 bucket. Tuy nhiên, một object được cấp phát từ callsite khác sẽ lấy object từ một randomized cache khác, kể cả khi nó cũng có kích thước 192 byte. Vậy cách spray một victim object khác trực tiếp vào slot vừa giải phóng của eventpoll theo mình là khó khả thi.
Để đưa một object thuộc cache khác vào slab trước đó được dùng bởi cache của eventpoll, mình sử dụng cross-cache attack, làm trống slab chứa object eventpoll để slab này được trả về buddy allocator, sau đó spray victim object ở cache khác để reclaim lại chính slab này từ buddy allocator.
Mình thử viết một Python script sử dụng pahole để lọc các object có kích thước lớn hơn 168 bytes và không vượt quá 192 bytes, đồng thời chứa field hữu ích nằm tại offset 152. Tuy nhiên sau khi đào sâu với AI, mình không tìm được object nào trong nhóm này thực sự phù hợp. Vì mình đang thực hiện cross-cache nên có thể không nhất thiết cần object mục tiêu phải nằm vào cache 192 bytes. Mình thử tìm kiếm các bài CTF, CVE writeup, papers… liên quan đến cross-cache attack để tham khảo ý tưởng và tìm được bài viết của Alexander Popov (https://a13xp0p0v.github.io/2026/04/20/pipe-buffer-experiments.html) về sử dụng cross-cache attack để ghi đè field flags của pipe_buffer, trigger lại lỗ hổng Dirty Pipe.
Making the pipe dirty again
Trước hết mình đi qua một vài context về lỗ hổng Dirty Pipe (CVE-2022-0847).
pipe là cơ chế IPC dạng FIFO trong Linux, cho phép một process ghi dữ liệu và process khác đọc dữ liệu theo thứ tự. Ví dụ đơn giản là lệnh cat file | grep abc, trong đó output của cat được ghi vào pipe và grep đọc lại từ pipe. Bên trong kernel, mỗi pipe được biểu diễn bởi cấu trúc pipe_inode_info:
struct pipe_inode_info {
	struct mutex               mutex;                /*     0    32 */
	wait_queue_head_t          rd_wait;              /*    32    24 */
	wait_queue_head_t          wr_wait;              /*    56    24 */
	/* --- cacheline 1 boundary (64 bytes) was 16 bytes ago --- */
	unsigned int               head;                 /*    80     4 */
	unsigned int               tail;                 /*    84     4 */
	unsigned int               max_usage;            /*    88     4 */
	unsigned int               ring_size;            /*    92     4 */
	unsigned int               nr_accounted;         /*    96     4 */
	unsigned int               readers;              /*   100     4 */
	unsigned int               writers;              /*   104     4 */
	unsigned int               files;                /*   108     4 */
	unsigned int               r_counter;            /*   112     4 */
	unsigned int               w_counter;            /*   116     4 */
	bool                       poll_usage;           /*   120     1 */

	/* XXX 7 bytes hole, try to pack */

	/* --- cacheline 2 boundary (128 bytes) --- */
	struct page *              tmp_page;             /*   128     8 */
	struct fasync_struct *     fasync_readers;       /*   136     8 */
	struct fasync_struct *     fasync_writers;       /*   144     8 */
	struct pipe_buffer *       bufs;                 /*   152     8 */
	struct user_struct *       user;                 /*   160     8 */

	/* size: 168, cachelines: 3, members: 19 */
	/* sum members: 161, holes: 1, sum holes: 7 */
	/* last cacheline: 40 bytes */
}
Trường bufs trỏ tới ring buffer chứa nhiều phần tử pipe_buffer.
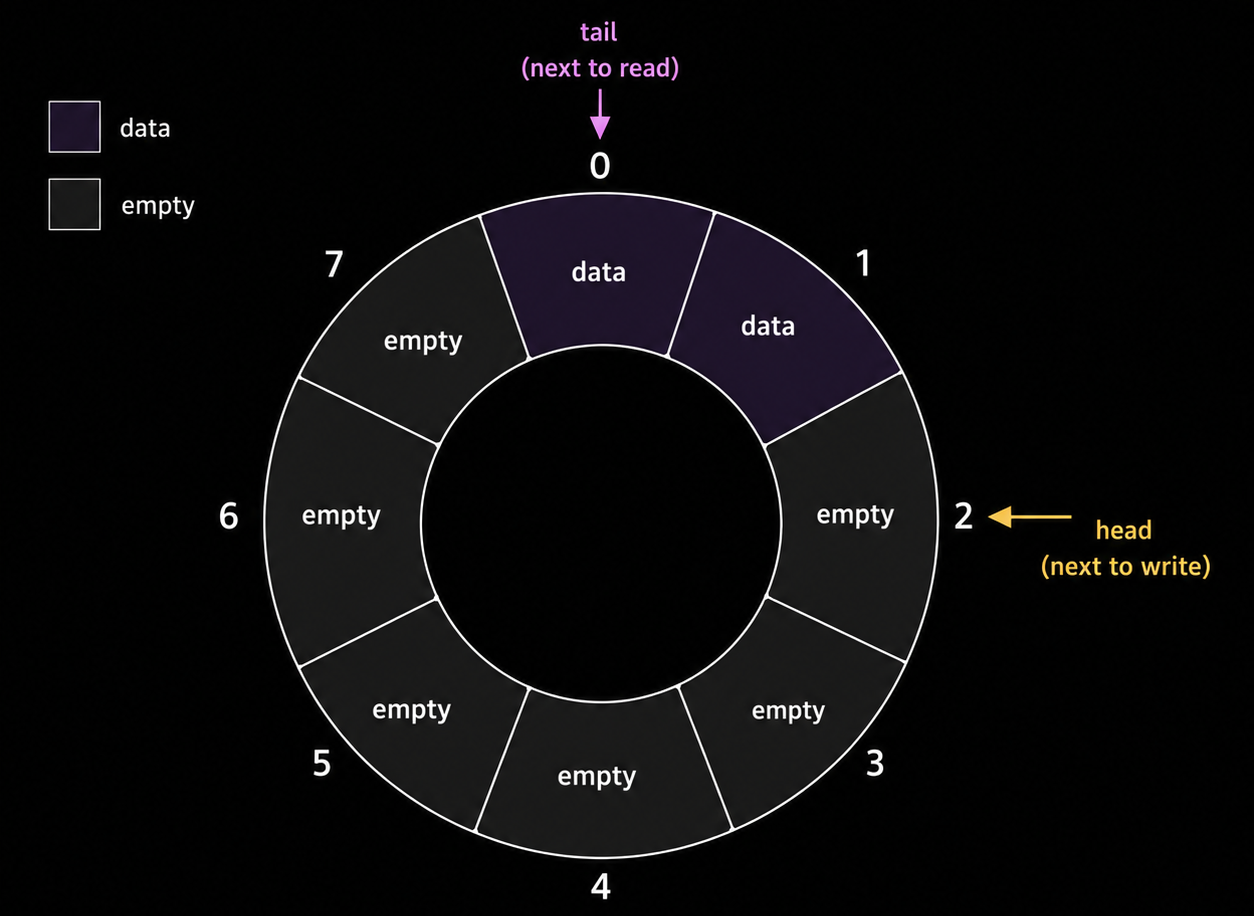
Mỗi pipe_buffer mô tả một vùng dữ liệu nằm trong một page của kernel, kèm metadata như offset, length và các cờ trạng thái:
struct pipe_buffer {
	struct page *              page;                 /*     0     8 */
	unsigned int               offset;               /*     8     4 */
	unsigned int               len;                  /*    12     4 */
	const struct pipe_buf_operations  * ops;         /*    16     8 */
	unsigned int               flags;                /*    24     4 */

	/* XXX 4 bytes hole, try to pack */

	long unsigned int          private;              /*    32     8 */

	/* size: 40, cachelines: 1, members: 6 */
	/* sum members: 36, holes: 1, sum holes: 4 */
	/* last cacheline: 40 bytes */
};
Mảng pipe_buffer trong pipe_inode_info có số lượng slot là luỹ thừa của 2. Dữ liệu mới được ghi vào vị trí head, rồi head tiến lên, dữ liệu được đọc tại tail, làm tail tiến lên, các slot được tái sử dụng. Pipe rỗng khi head == tail.
Biết rằng Linux sử dụng page cache cho hầu hết thao tác I/O trên file: khi đọc file, dữ liệu được nạp vào page cache trong RAM rồi mới trả về userspace; khi ghi file, kernel cũng cập nhật page cache trước rồi mới flush xuống đĩa.
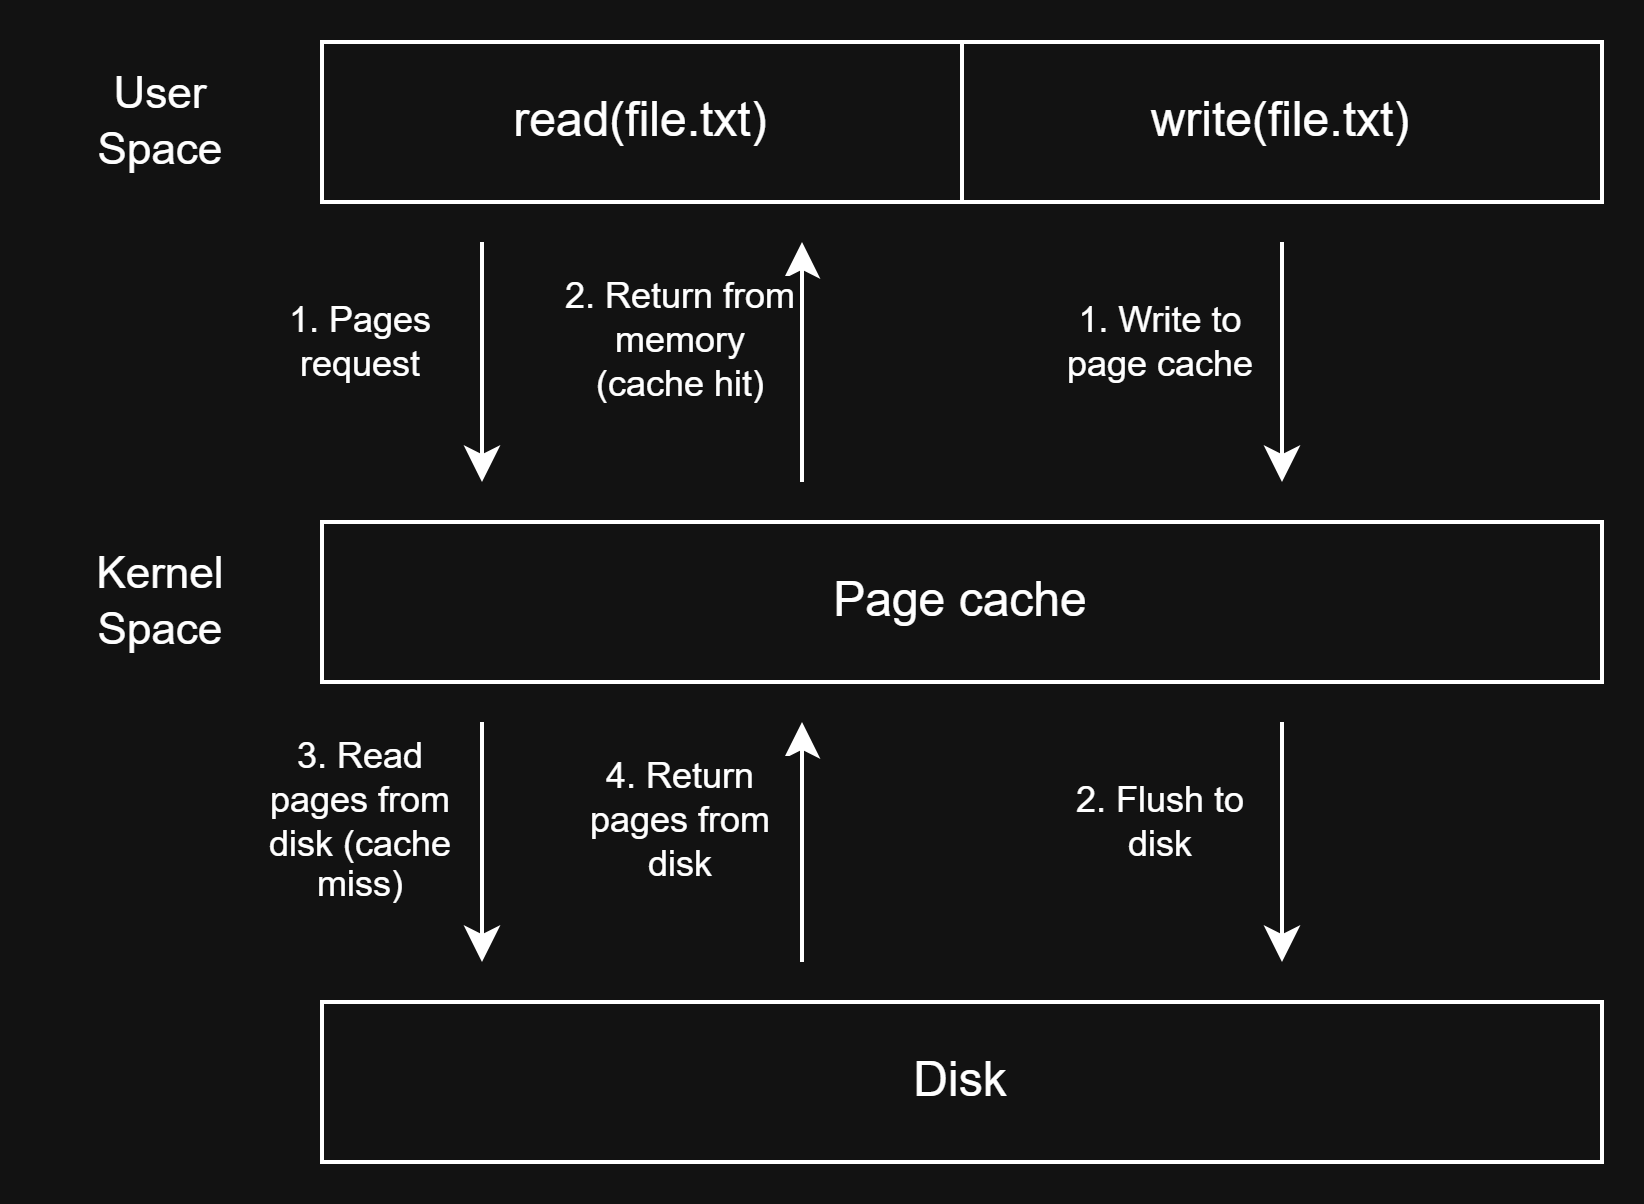
Với một anonymous pipe thông thường, khi process gọi write(), kernel sẽ copy dữ liệu từ userspace vào các page mới thuộc sở hữu của pipe và mỗi pipe_buffer chỉ mô tả phần dữ liệu nằm trong các page này. Nếu muốn đưa dữ liệu từ file vào pipe theo cách thông thường, kernel phải copy dữ liệu từ page cache sang page riêng của pipe:
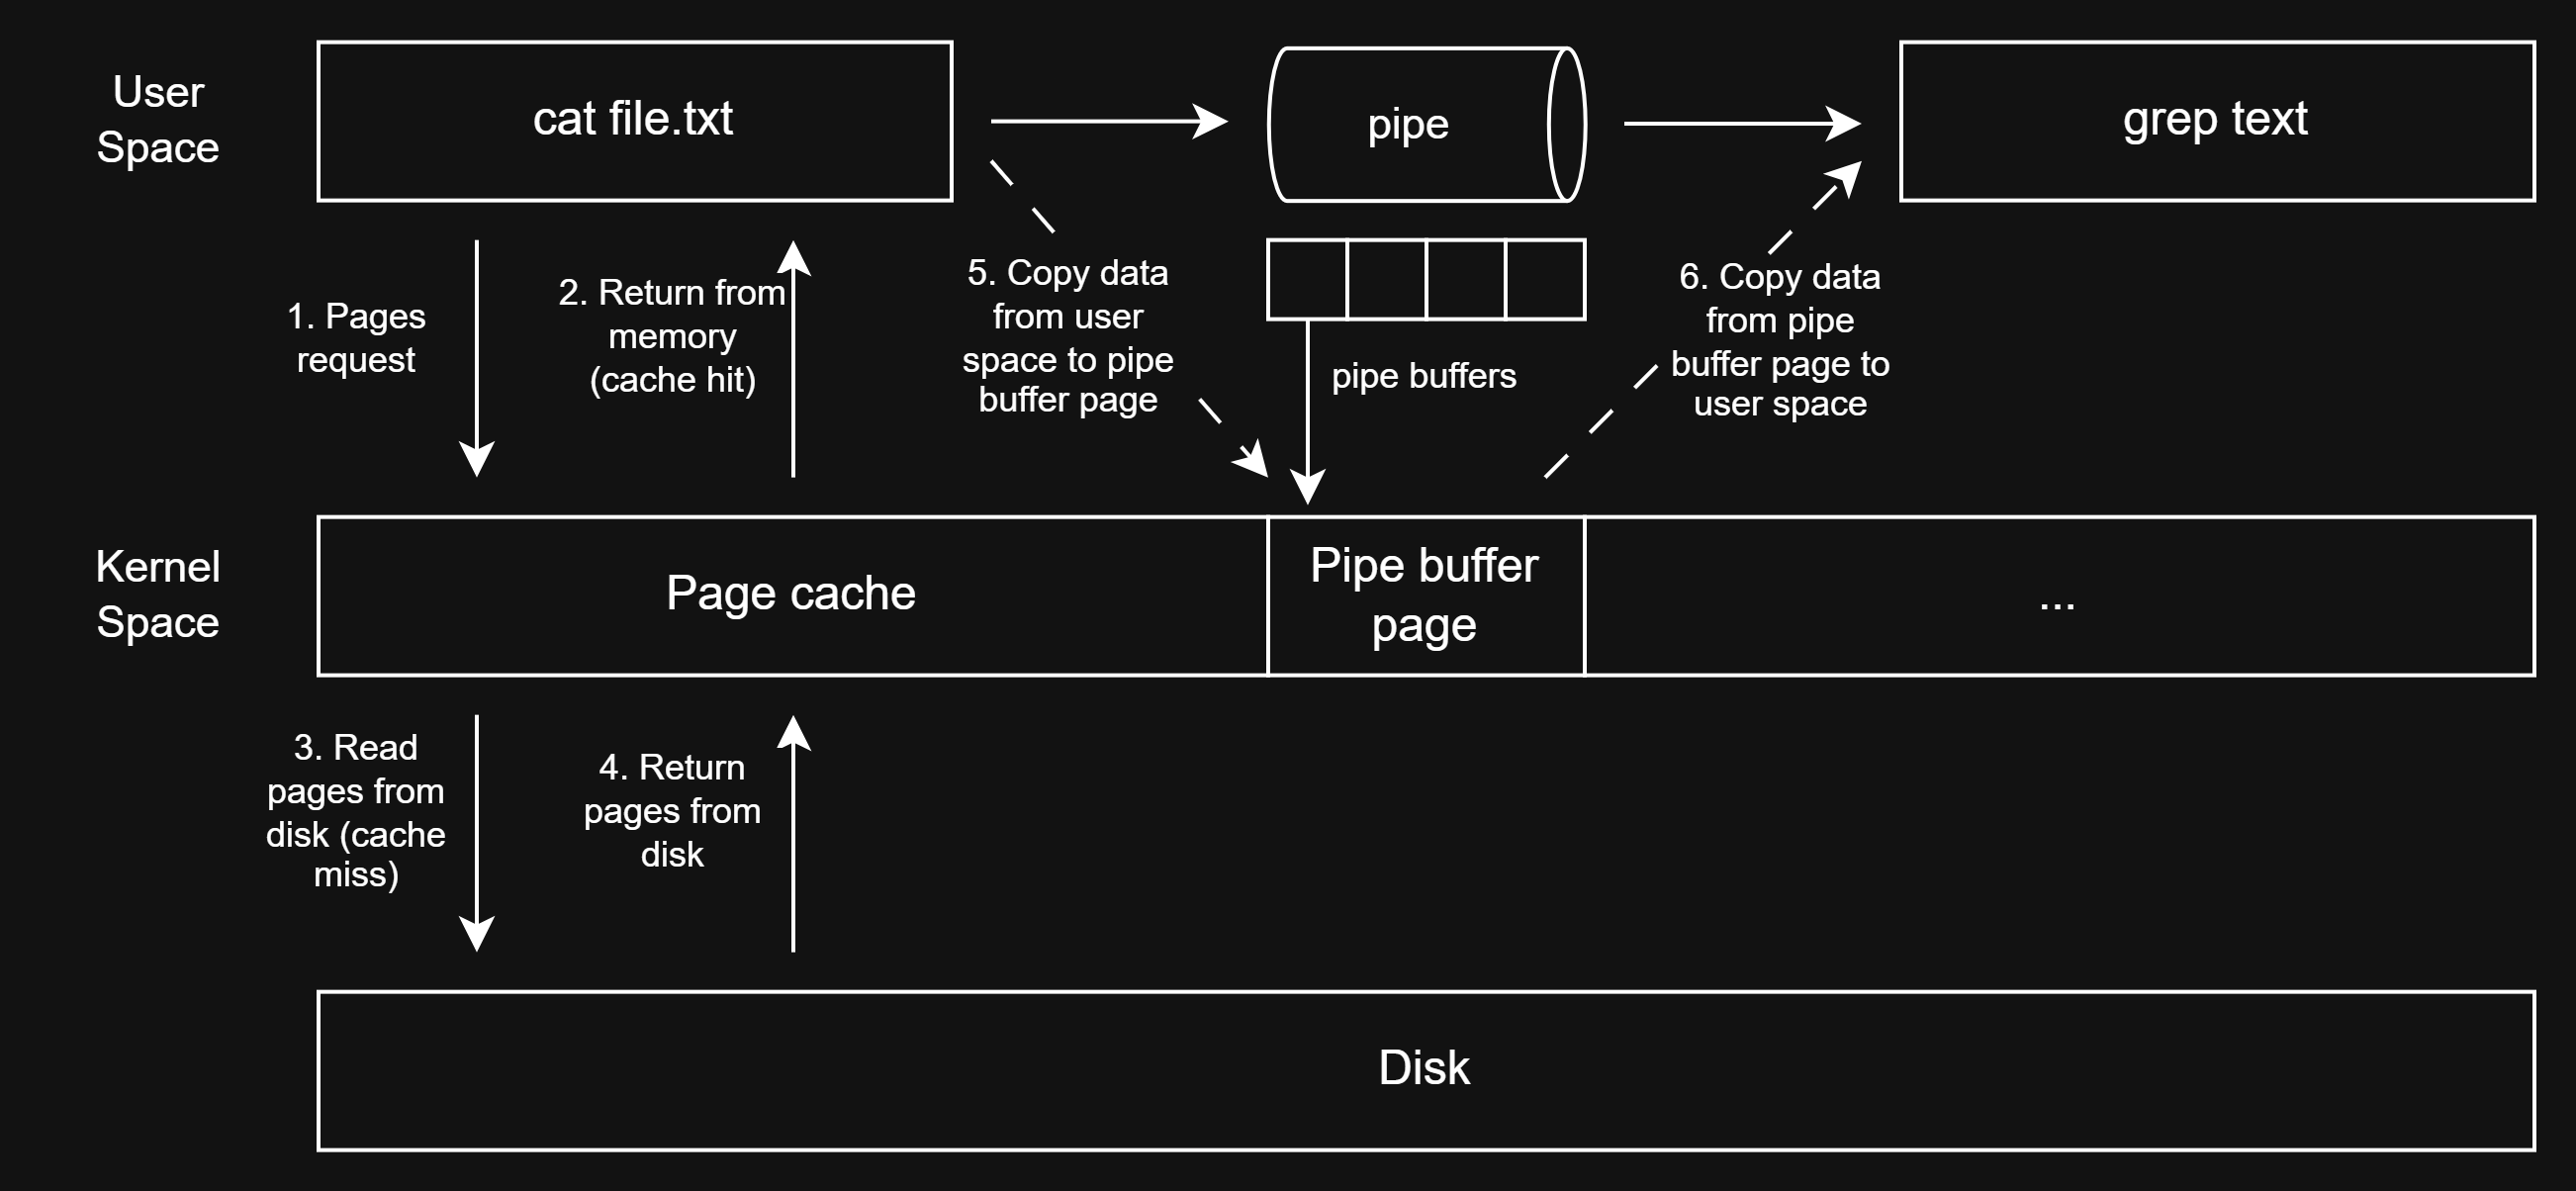
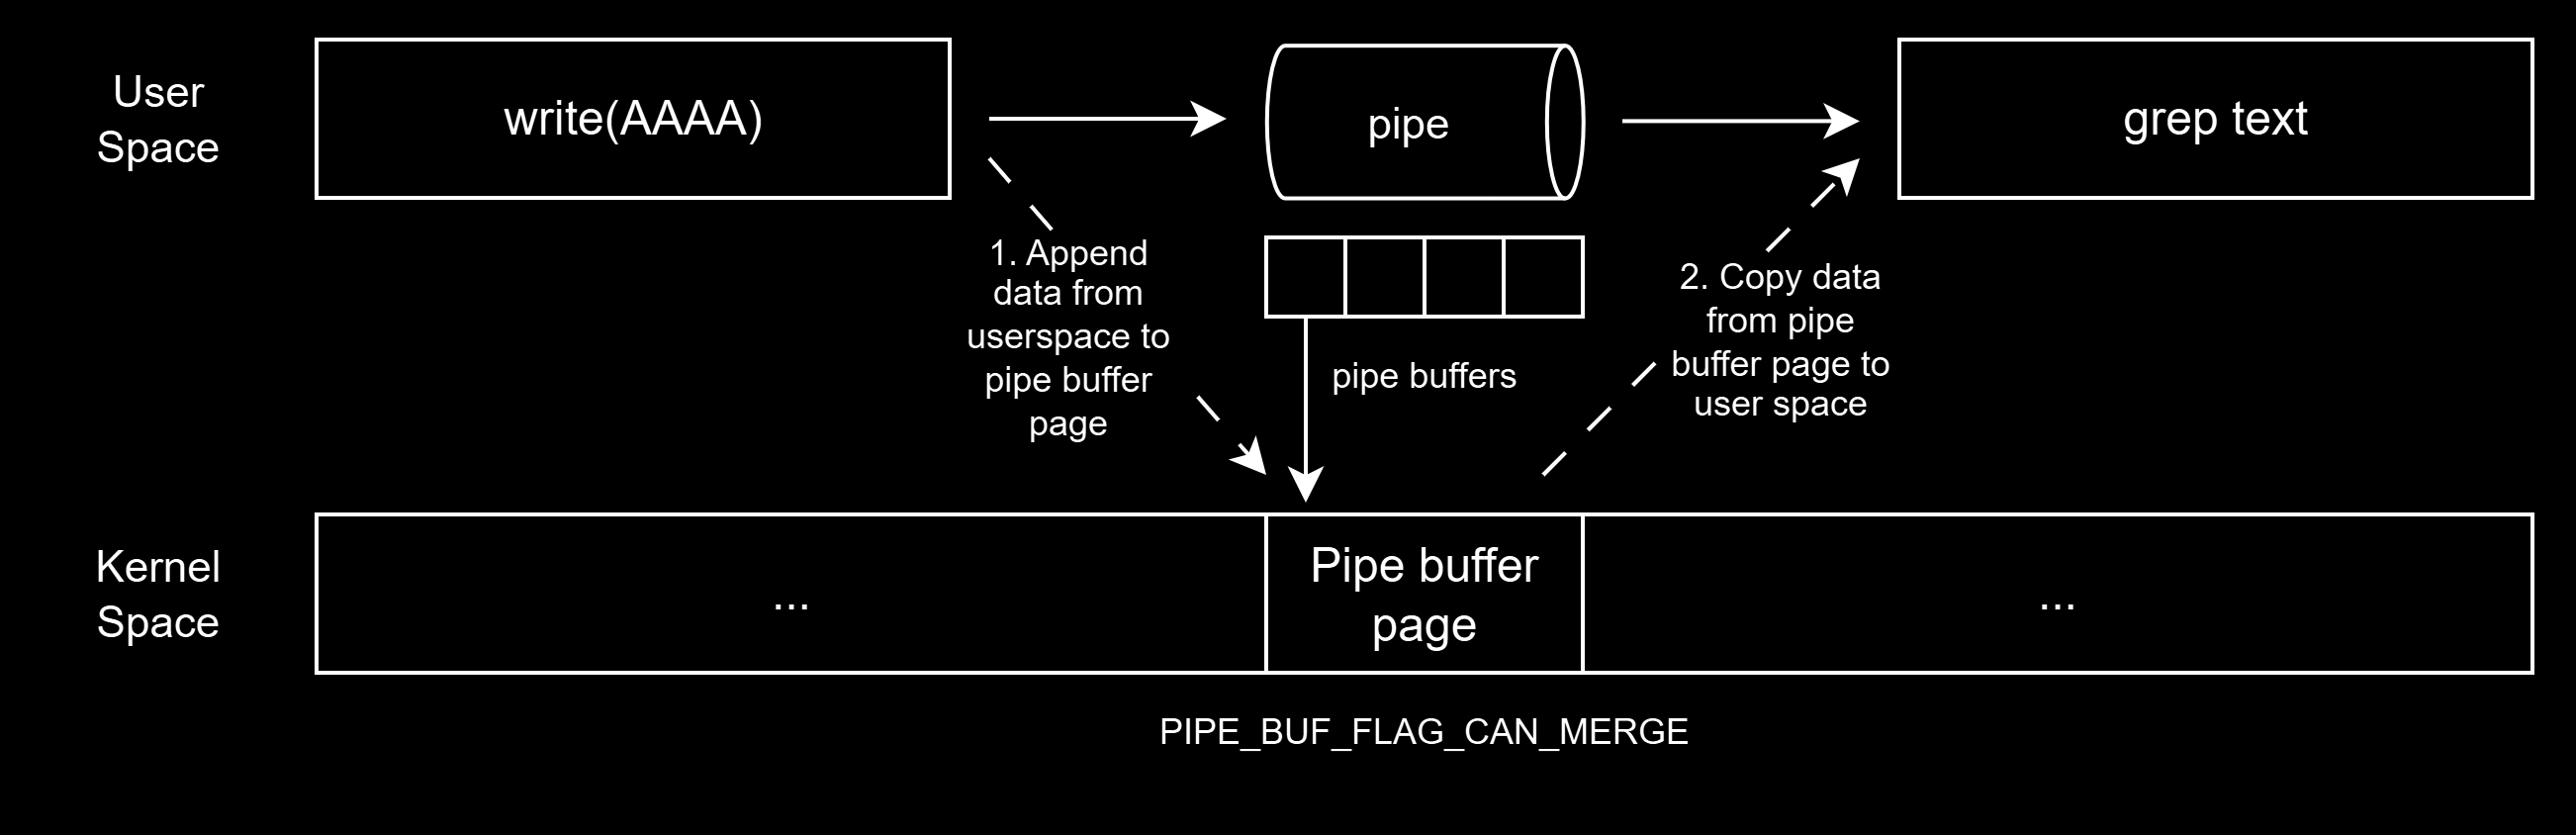
Một flag quan trọng của pipe_buffer là PIPE_BUF_FLAG_CAN_MERGE, cho phép dữ liệu được ghi tiếp theo vào pipe có thể được nối trực tiếp vào page hiện tại thay vì phải sử dụng slot mới:
Tuy nhiên Linux cung cấp system call splice() để tối ưu quá trình này bằng cơ chế zero-copy. Thay vì tạo page mới và copy dữ liệu, splice() chỉ tạo một pipe_buffer tham chiếu trực tiếp tới page cache của file nguồn. Giờ pipe không còn chứa bản sao dữ liệu riêng mà đang tham chiếu thẳng tới page cache của file:
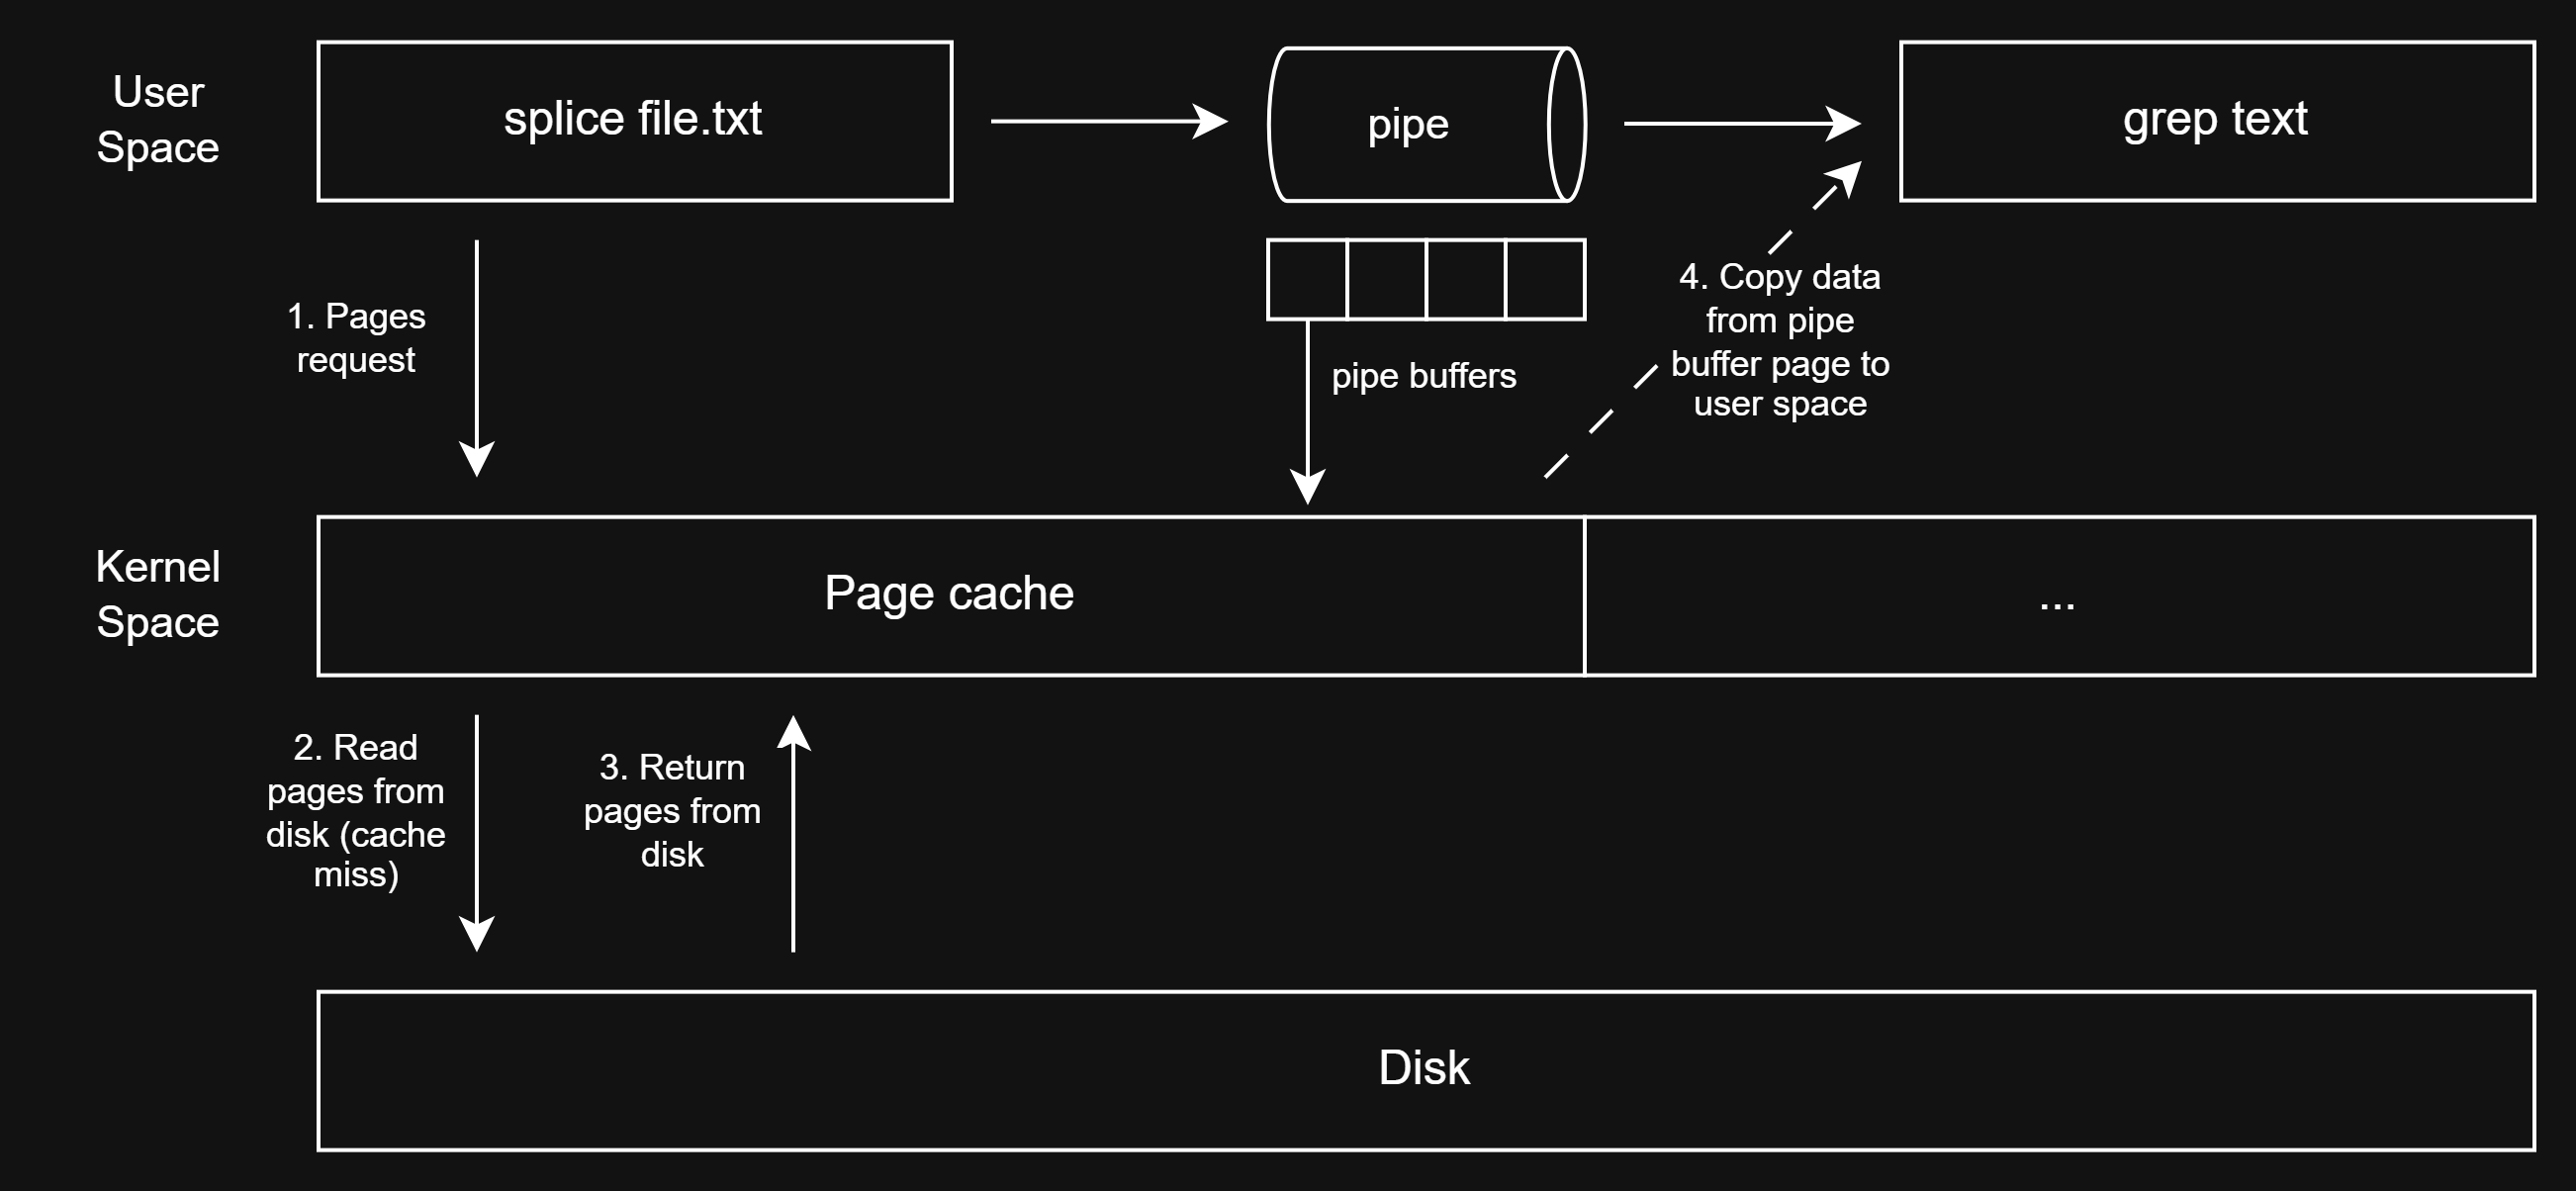
Lỗ hổng xảy ra khi một pipe được ghi dữ liệu cho tới khi toàn bộ các slot pipe_buffer đều được sử dụng, sau đó đọc hết dữ liệu ra để các slot đó trở thành trống và sẵn sàng được tái sử dụng. Tuy nhiên trường flags không được reset hoàn toàn. Dẫn đến một pipe_buffer được tạo bởi splice() từ page cache của file có thể có cờ PIPE_BUF_FLAG_CAN_MERGE:
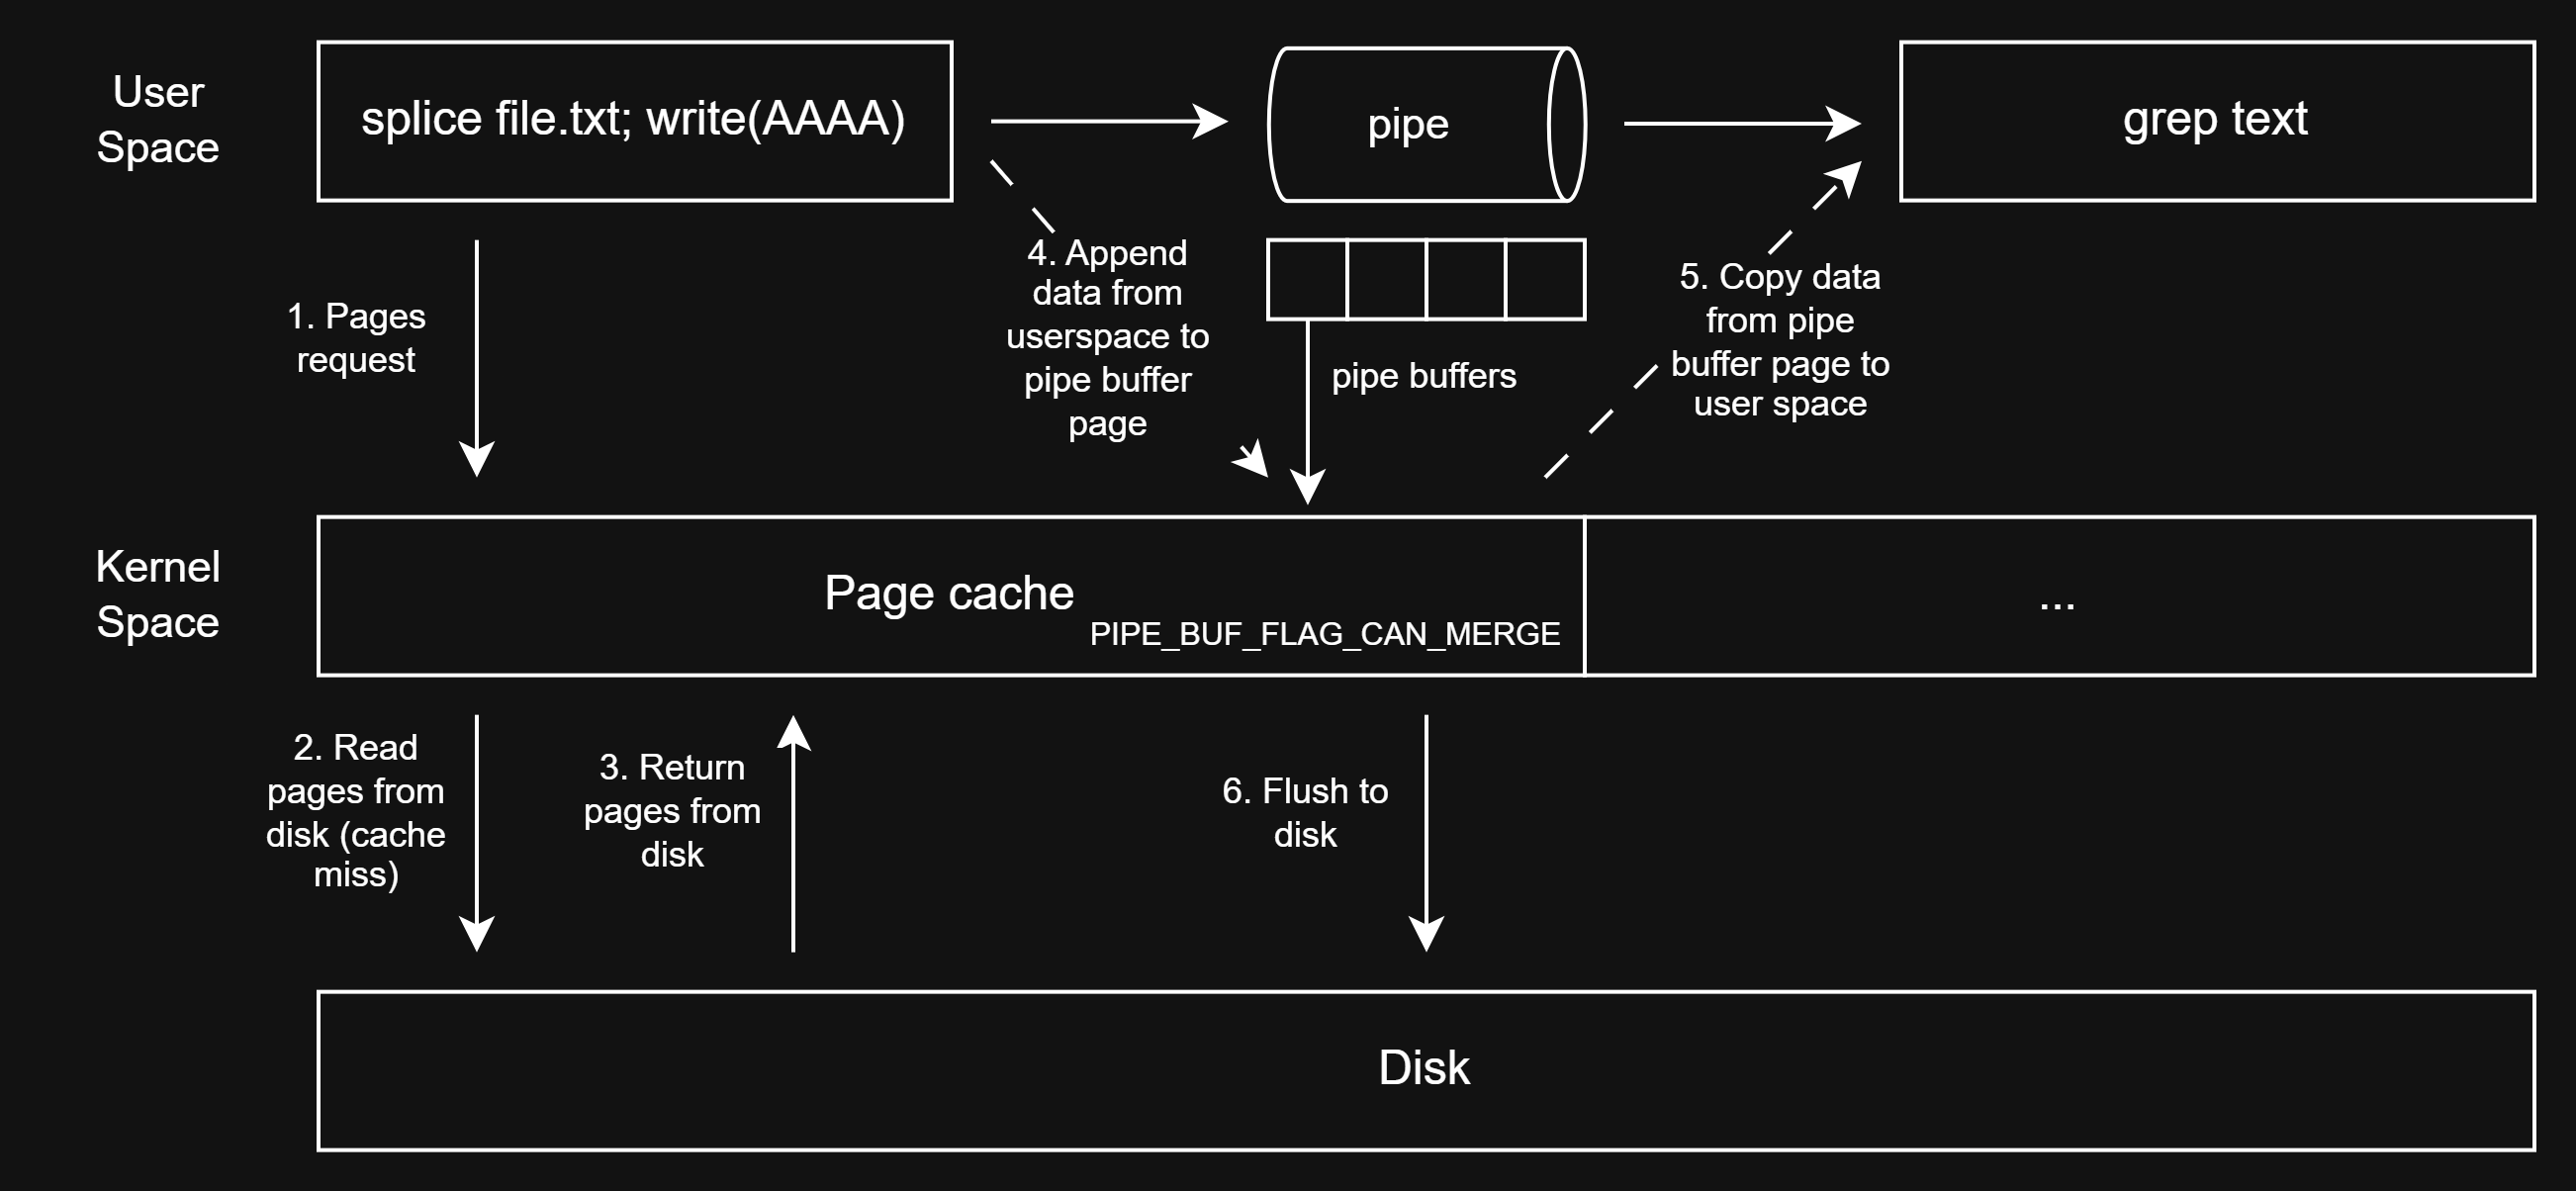
Khi process gọi write() vào pipe, kernel tin rằng dữ liệu mới có thể merge vào page được tham chiếu bởi pipe_buffer hiện tại. Tuy nhiên page đó không phải page riêng của pipe mà chính là page cache của file nguồn. Vậy nên dữ liệu ghi vào pipe thực chất ghi đè trực tiếp lên page cache của file, kể cả khi file được mở chỉ đọc. Do page cache cuối cùng sẽ được flush xuống disk, attacker có thể sửa đổi nội dung file tuỳ ý mà không cần quyền ghi.
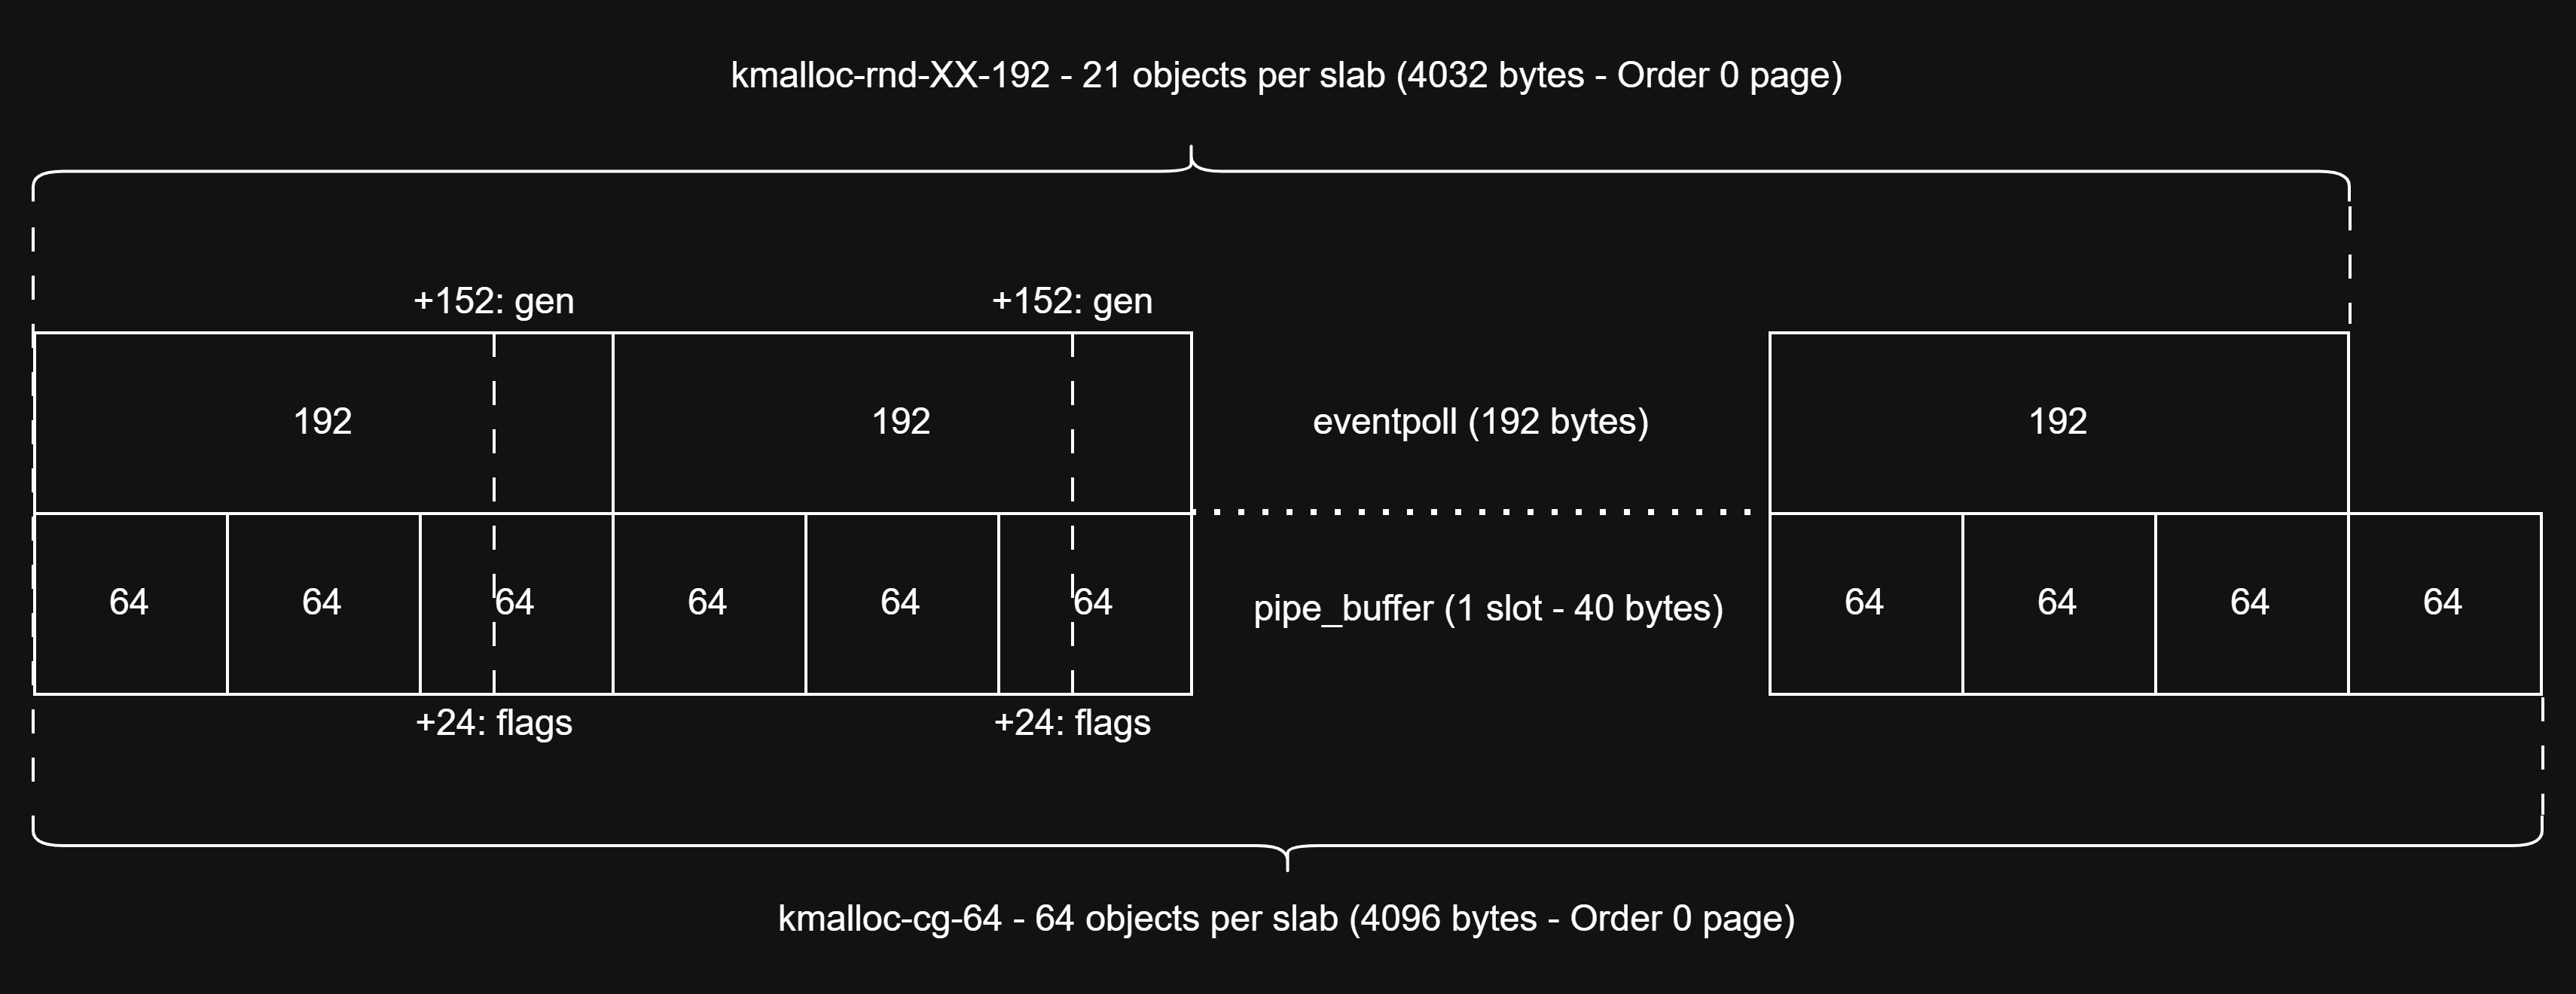
Theo môi trường thử nghiệm của mình, với chỉ 2 CPU core, mỗi slab trong kmalloc-rnd-XX-192 chứa 21 object với tổng kích thước 4032 bytes, nên slab này được cấp phát từ buddy allocator với page order 0. Trong khi đó pipe_buffer được cấp phát từ các cache kmalloc-cg-XX, mà các cache cũng sử dụng slab order 0 thì lựa chọn còn lại chỉ gồm các size 64, 96, 128, 192 và 256. Primitive hiện tại cho phép ghi vào field gen của eventpoll tại offset 152, trùng với field flags của pipe_buffer tại offset 24 nếu mỗi pipe_inode_info chỉ chứa một slot:
Attack plan
Đến đây, mình có thể xây dựng một kế hoạch exploit như sau:
- Tại CPU 1, spray
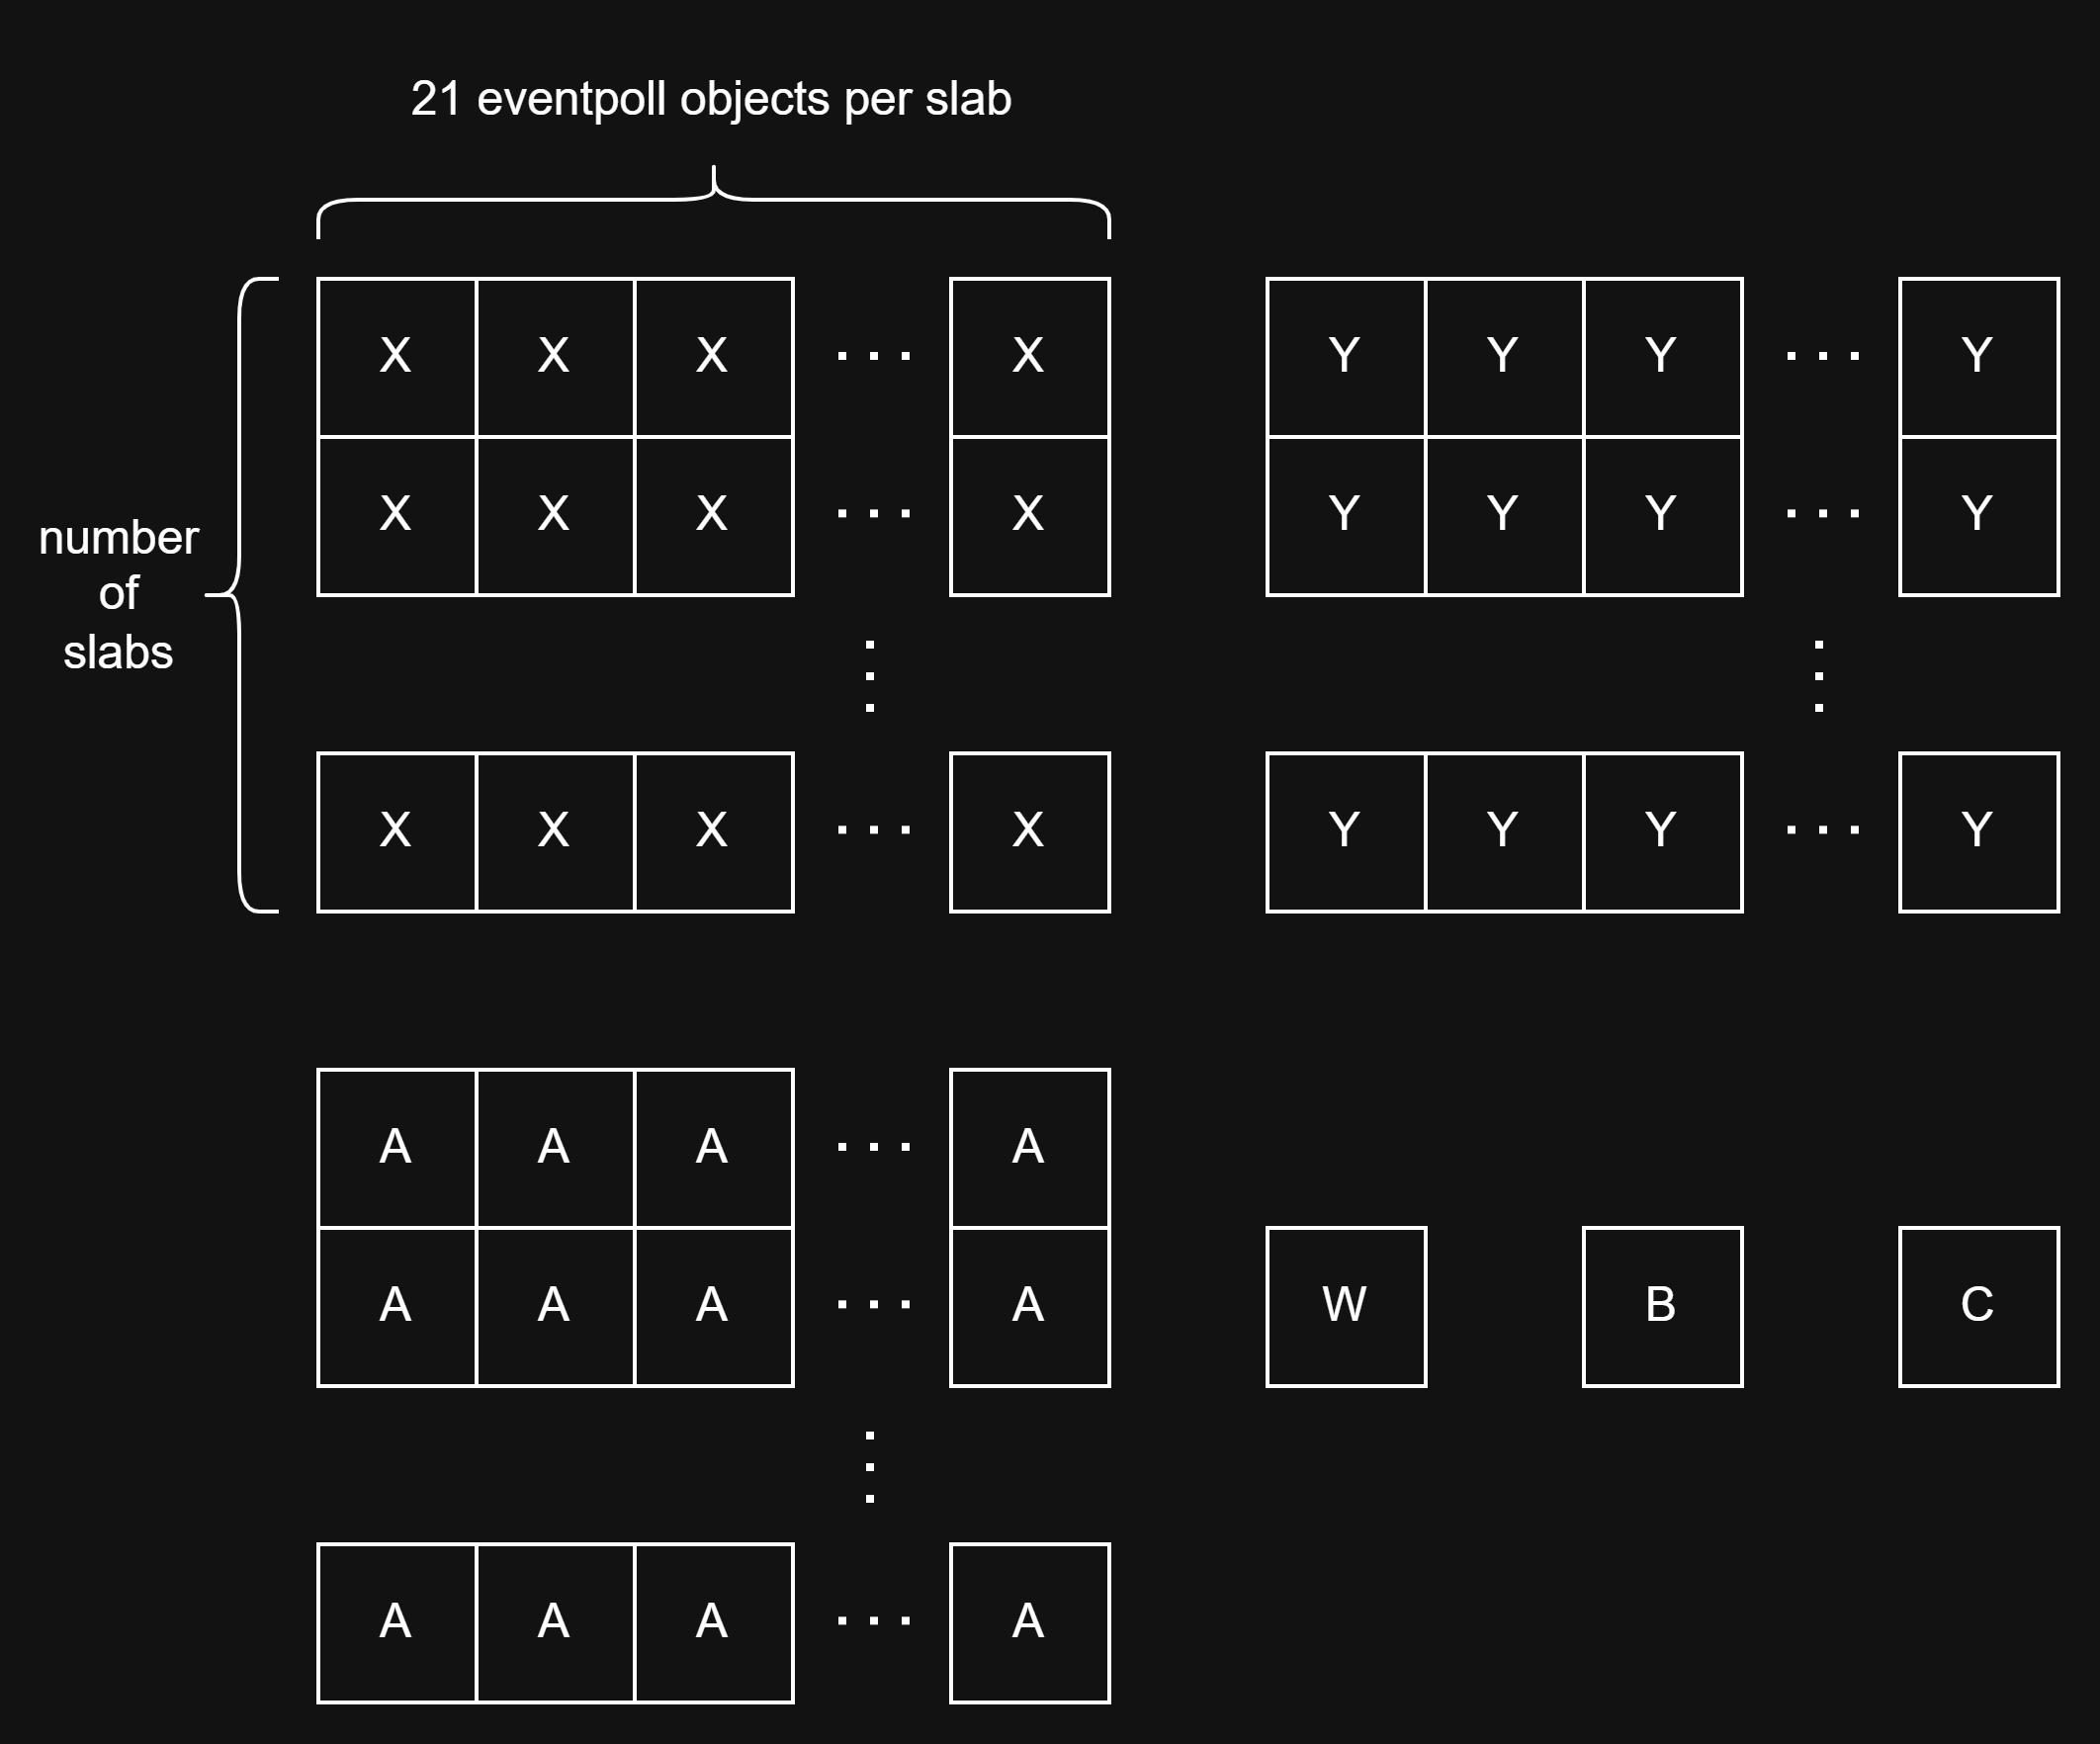
eventpollđể drain toàn bộ partial slab hiện tại trongkmalloc-rnd-XX-192. Mục tiêu là tạo topology gồmn X,n Y,1 W,n A,1 B,1 C, trong đó nhómAđược sử dụng ở các bước tiếp theo.
Vẫn tại CPU 1, với mỗi slab thuộc nhóm
A, free 20 object và giữ lại 1 object. Khi đókmalloc-rnd-XX-192sẽ phải theo dõi nhiều partial slab hơn bình thường. Khi object cuối cùng trong một slab được giải phóng, slab đó có khả năng được trả về PCP cache order-0, migration typeUNMOVABLEcủa CPU 1.Chọn một object
Achưa bị free, ví dụ object nằm giữa các object còn sống, rồi hoàn thiện topology thànhn X -> n Y -> W -> A -> B.
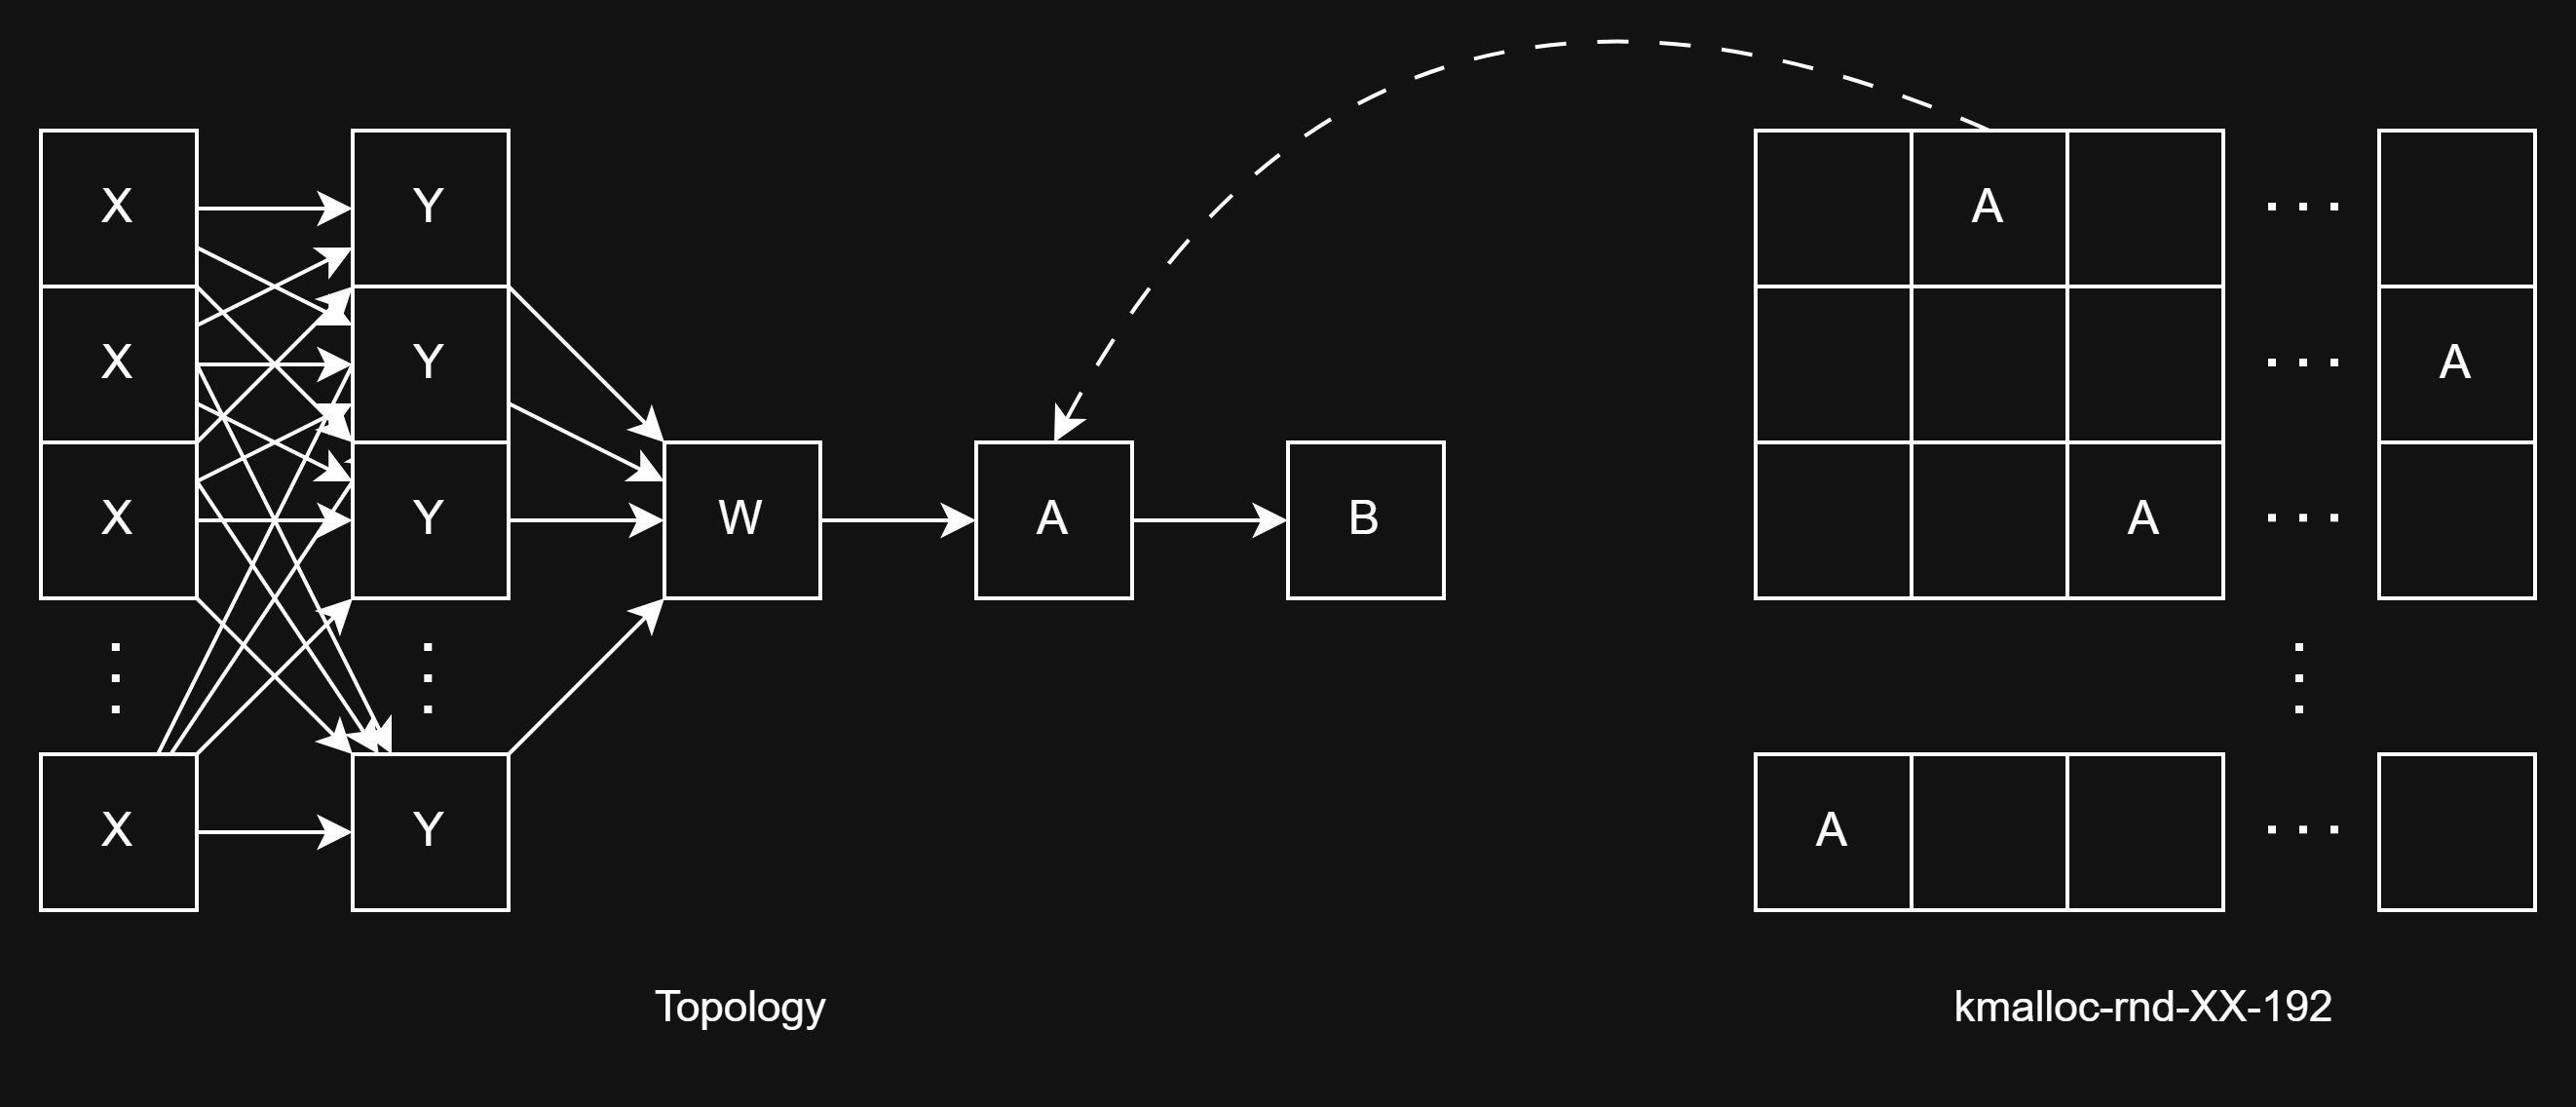
Tại CPU 2, trigger bằng cách cho
BwatchC.Đồng thời tại CPU 1, free object
Ađã chọn. Lúc này một slab trống hoàn toàn được trả về PCP cache.
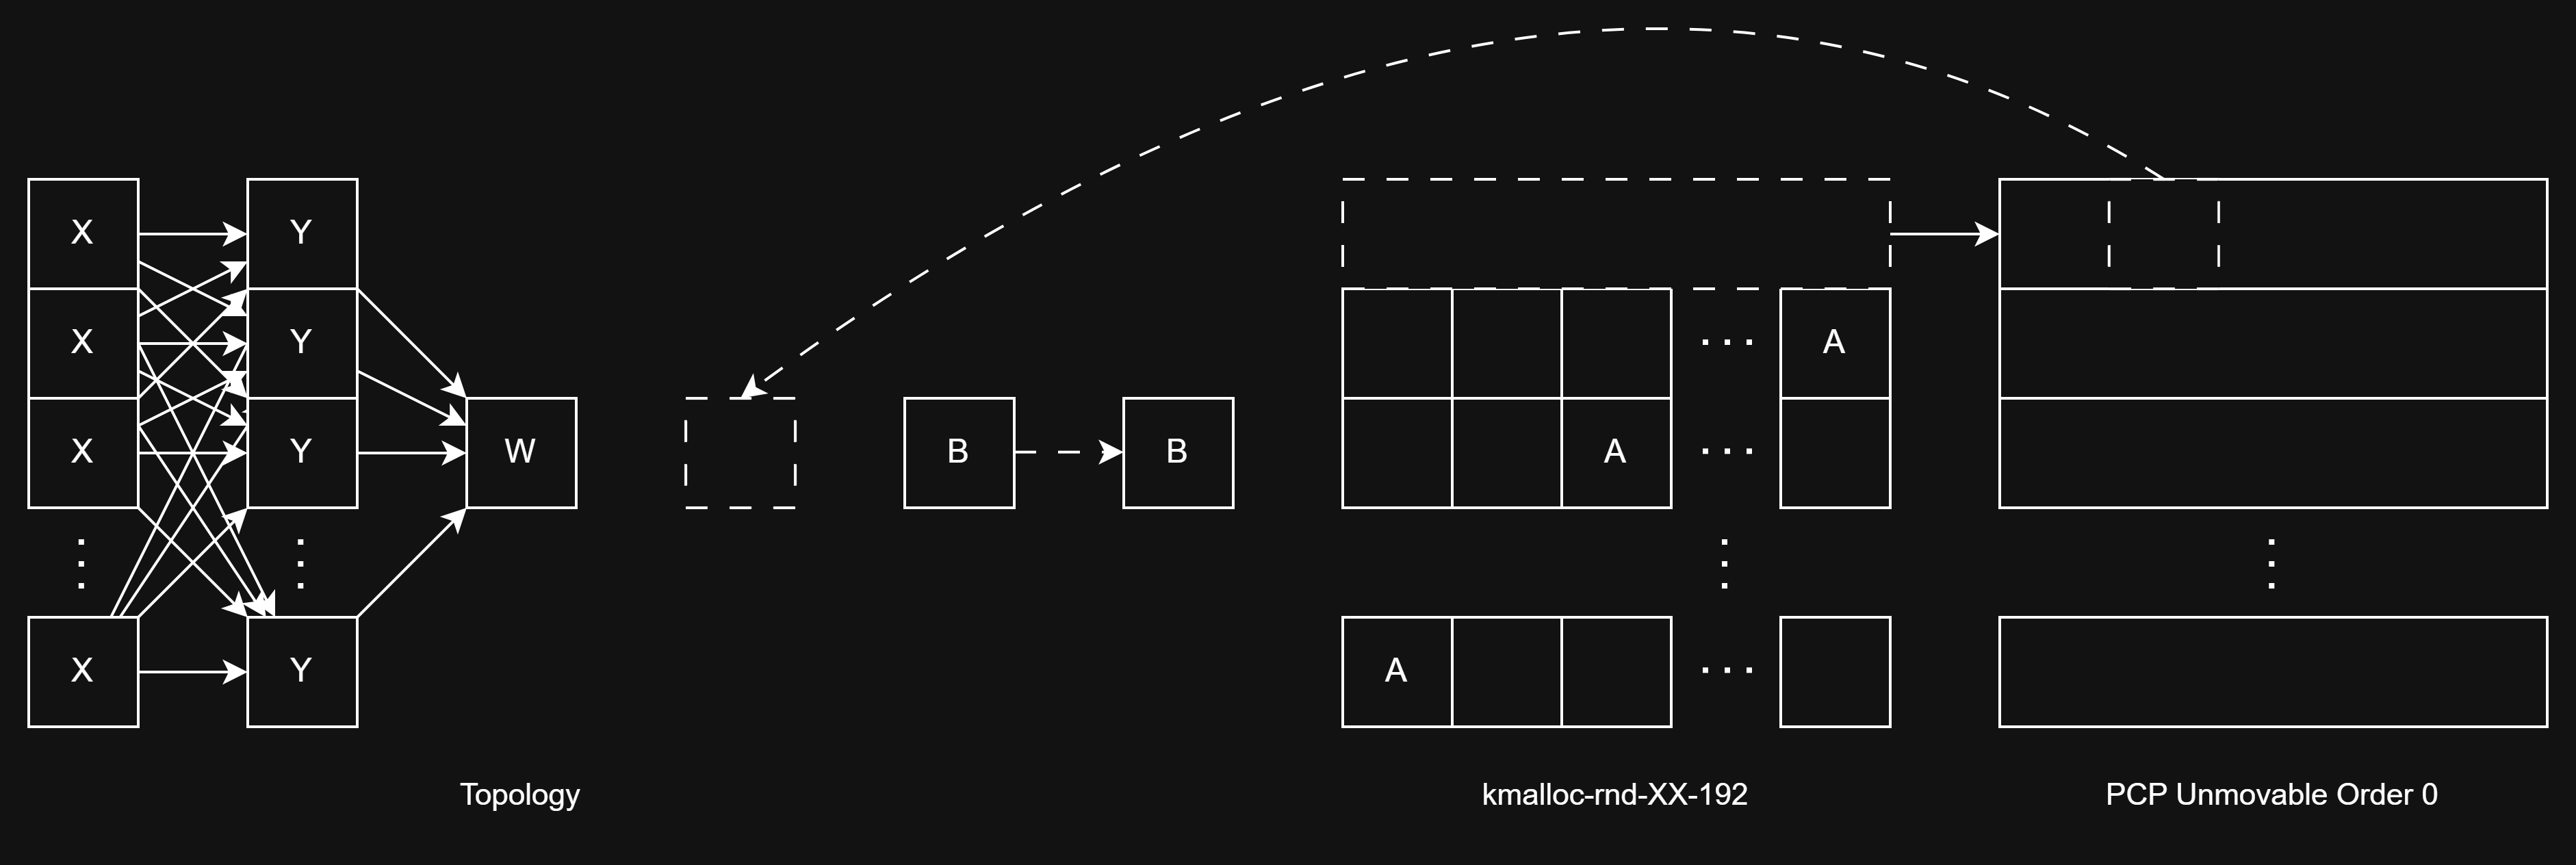
Ngay sau đó spray số lượng lớn pipe_buffer để reclaim slab vừa được giải phóng, rồi với mỗi pipe_buffer thực hiện splice() từ /etc/passwd vào pipe để flags được reset về 0 trước khi ghi vào ep->gen:
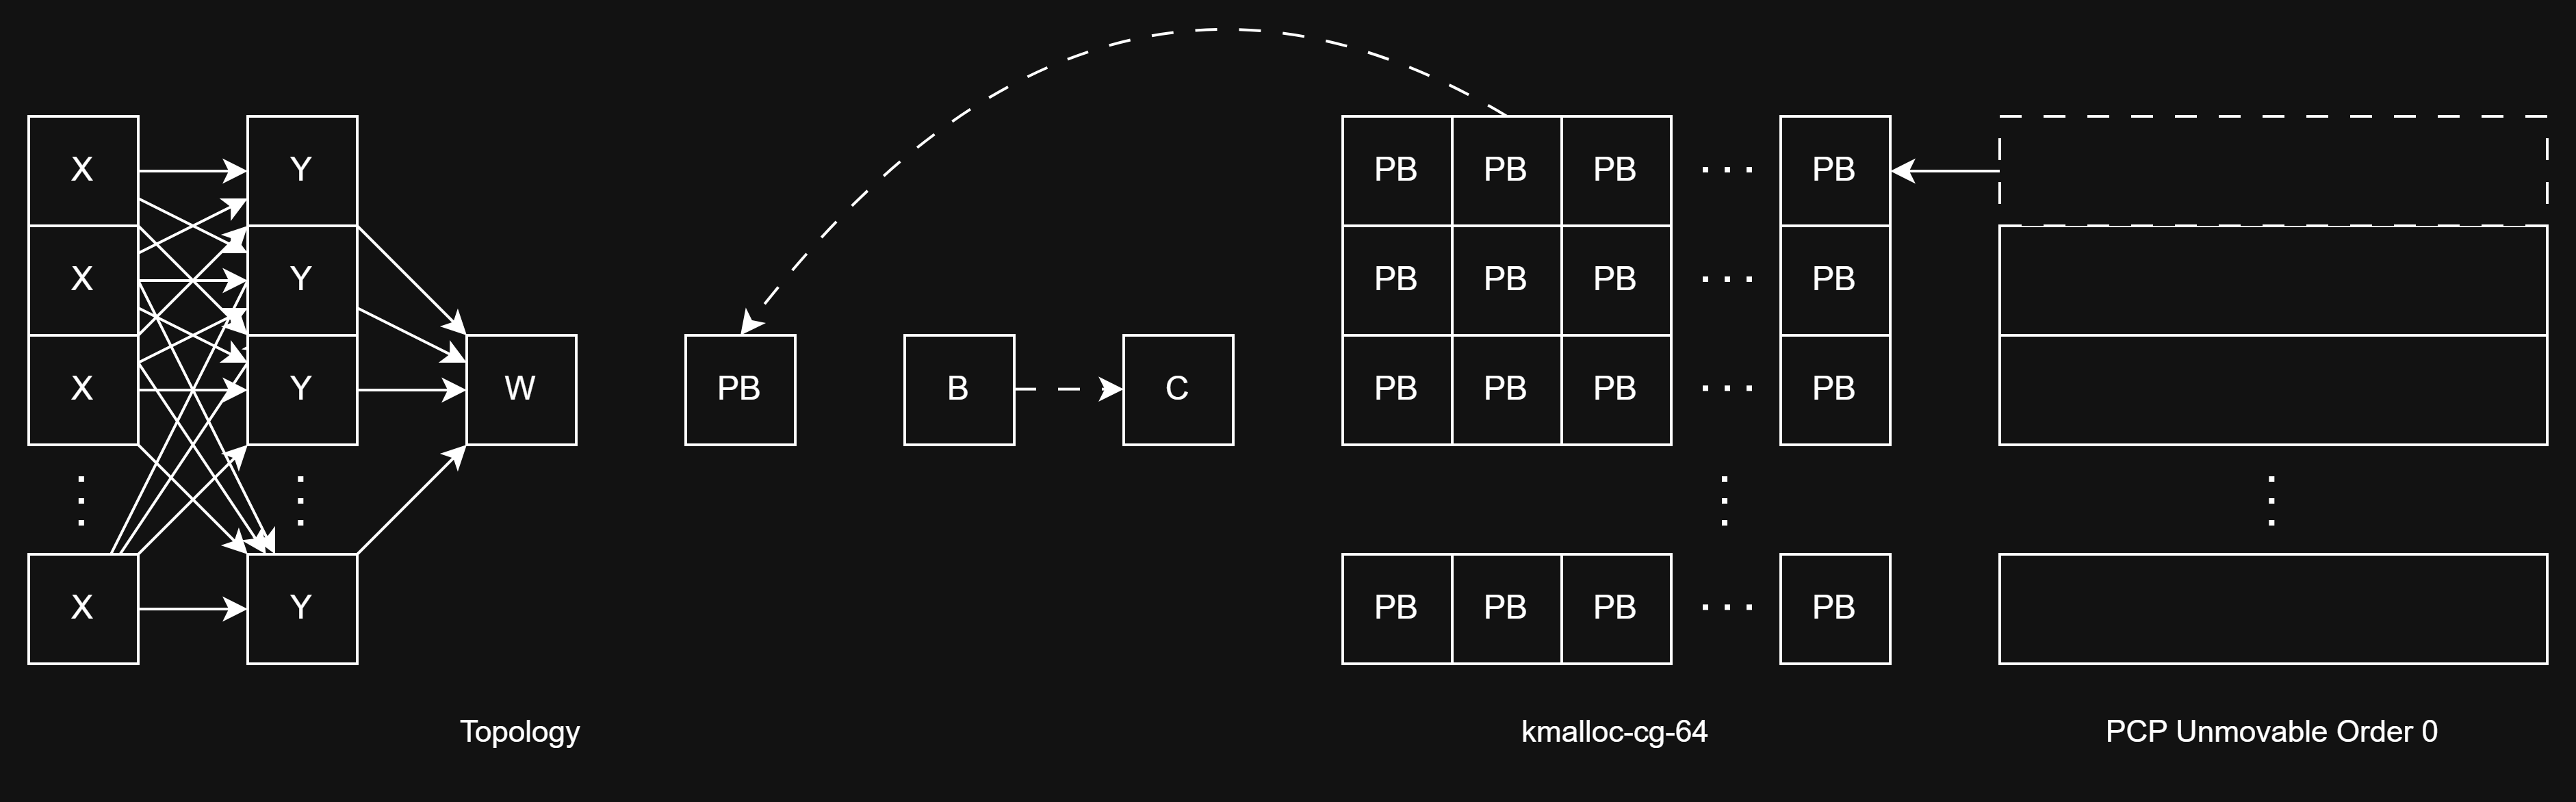
Sau khi traversal qua
X,YvàWtừA, giá trịloop_check_genđược ghi vàoep->gen, đồng thời cũng ghi đè lênpipe_buffer->flagssao choflags & 0x10 == 0x10(PIPE_BUF_FLAG_CAN_MERGE).Ghi dữ liệu vào pipe để sửa nội dung
/etc/passwd, sau đó đọc lại file để kiểm tra kết quả. Nếu ghi đè không thành công thì thực hiện cleanup và quay lại bước 1.
Demo
Video dưới đây demo PoC của mình trên Ubuntu 24.04 Desktop với Linux Kernel 6.17.0-35-generic, phiên bản mặc định mới nhất cho user, sử dụng config mặc định, với tỉ lệ thành công đến 99%:
Tỉ lệ thành công của PoC phụ thuộc nhiều vào độ lớn của race window. Càng có nhiều RAM và càng tạo được nhiều file descriptor thì khả năng thành công càng cao, do quá trình traversal phải đi qua một topology dày đặc hơn. Khi thời gian traversal tăng lên, khả năng thread còn lại free và reclaim object cũng tăng theo.
Ngoài ra, Ubuntu 24.04 Desktop còn bật CONFIG_PREEMPT_RCU, cho phép các RCU reader bị preempt ngay cả khi đang nằm trong RCU read-side critical section. Nếu task thực hiện traversal đủ lâu để bị scheduler preempt giữa chừng, lại càng mở rộng race window và làm tăng tỉ lệ thành công.
Notes
Với trường hợp CONFIG_PREEMPT_RCU bị tắt, để tăng tỉ lệ thành công, thay vì kéo dài race window, chúng ta rút ngắn thời gian reclaim bằng cách pin thread sang một CPU khác để thực hiện splice() ngay sau khi cấp phát pipe_buffer. Giúp tăng tốc độ spray tại CPU 1, còn splice() được thực hiện đồng thời trên CPU khác.
Ngoài ra, vấn đề còn tồn tại đó là khi số lượng CPU từ 8 trở lên, các cache cho 192 bytes sử dụng slab với kích thước là Order-1 page. Dẫn đến pipe_buffer không còn là object phù hợp để spray, khi lượng slot phải là luỹ thừa của 2, gen không thể rơi trúng vào flags. Hiện mình vẫn chưa tìm ra được object nào phù hợp cho trường hợp trên.
Affected range
Hiện theo mình tìm hiểu, lỗ hổng chỉ còn khai thác được trên Ubuntu 24.04 cho đến Linux Kernel 6.17. Trên các phiên bản mới hơn như Ubuntu 26.04 với Linux Kernel 7.0 hoặc Red Hat Enterprise Linux 10.2, dù lỗi vẫn tồn tại vì ep_free() vẫn gọi trực tiếp kfree(ep), nhưng hàm ep_get_upwards_depth_proc() không còn được sử dụng. Thay vào đó sử dùng reverse_path_check_proc() có vai trò gần tương tự trong quá trình traversal:
static void ep_free(struct eventpoll *ep)
{
	ep_resume_napi_irqs(ep);
	mutex_destroy(&ep->mtx);
	free_uid(ep->user);
	wakeup_source_unregister(ep->ws);
	kfree(ep);
}
static int reverse_path_check_proc(struct hlist_head *refs, int depth)
{
int error = 0;
struct epitem *epi;
if (depth > EP_MAX_NESTS) /* too deep nesting */
return -1;
/* CTL_DEL can remove links here, but that can't increase our count */
hlist_for_each_entry_rcu(epi, refs, fllink) {
struct hlist_head *refs = &epi->ep->refs;
if (hlist_empty(refs))
error = path_count_inc(depth);
else
error = reverse_path_check_proc(refs, depth + 1);
if (error != 0)
break;
}
return error;
}Tuy nhiên, không có bất kỳ read primitive hay write primitive hữu ích nào trên UAF object mà mình có thể khai thác sau khi thắng race.
References
- Linux kernel stable commit 5b1173b16542
- Some notes on the security properties of the pipe_buffer kernel object
- The Dirty Pipe Vulnerability
- GitHub - jamesbrunet/dirtypipe-writeup
- A Quick Dive Into The Linux Kernel Page Allocator
- 2024, LSS EU: SLUB Internals for Exploit Developers
- CVE-2022-27666: Exploit esp6 modules in Linux kernel